Кластер Hadoop может одновременно выполнять ежедневную загрузку данных, аналитический запрос и пересчёт архива. Несколько команд запрашивают память и процессоры одних и тех же серверов. Если каждый процесс займёт всю память, соседние задачи перестанут нормально работать. Нужен общий порядок: кому, на какой машине и сколько ресурсов выделить.
Этим занимается YARN — слой управления ресурсами Hadoop. Он не знает, как группировать записи или разбирать CSV. Правила вычисления приносит приложение, например MapReduce или Spark.
До появления YARN ранняя реализация Hadoop связывала управление вычислительными ресурсами с MapReduce. Выделение этой обязанности в отдельный слой позволило разным движкам совместно использовать кластер. Поэтому в одной платформе могут одновременно выполняться MapReduce, Spark и другие приложения: они запрашивают ресурсы, но сохраняют собственную логику расчёта.
Данные остаются, например, в HDFS. YARN выделяет ресурсы для процессов, которые эти файлы прочитают.
ResourceManager, NodeManager и ApplicationMaster
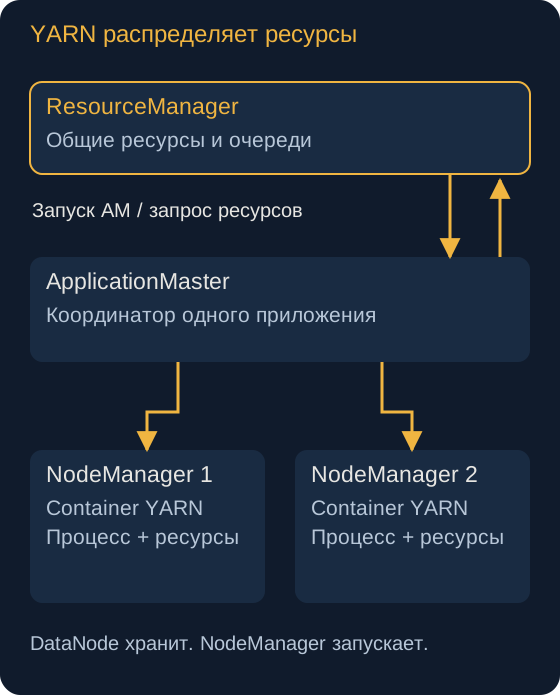
ResourceManager, RM, видит доступные ресурсы кластера и распределяет их между приложениями. NodeManager, NM, работает на отдельном узле: запускает назначенные процессы, наблюдает их состояние и сообщает о ресурсах.
Одному приложению нужен собственный координатор — ApplicationMaster, AM. Он договаривается с RM о ресурсах для своей работы и взаимодействует с NodeManager для запуска задач. У каждого приложения свой AM, а RM обслуживает весь кластер.
Container YARN — выделенная порция ресурсов на узле и окружение запуска процесса. Например, приложению дали 2 GB памяти и один виртуальный CPU. Это не образ Docker и не обязательный Docker-контейнер: слово container здесь обозначает другой уровень управления.
Как начинается расчёт
- Клиент отправляет описание приложения: что запускать, какие файлы нужны и в какой очереди работать.
- RM выделяет первый container для ApplicationMaster; NodeManager запускает его.
- AM запрашивает ресурсы для рабочих процессов. Получив назначения, он организует их запуск через NodeManager.
- Рабочие процессы читают вход, вычисляют результат и записывают выход. AM следит за выполнением своего приложения.
- После завершения ресурсы освобождаются для других работ.
На одном сервере могут одновременно находиться DataNode и NodeManager. Первый отвечает за блоки HDFS, второй — за вычислительные процессы. Дисковое место HDFS и память вычислительных процессов учитываются отдельно.
Один запуск на числах
Допустим, после размещения AM приложению нужны четыре рабочих процесса по 2 GB памяти и одному виртуальному CPU. Если сейчас доступно место только для двух, часть работы может начаться на них, а следующая — после освобождения ресурсов. Конкретный способ использования выданных ресурсов определяется движком: MapReduce запускает задачи, Spark использует executors для множества задач.
Виртуальный CPU здесь — единица учёта для планировщика; её нельзя без проверки конфигурации приравнивать к выделенному физическому ядру. И 2 GB контейнера не обязательно целиком доступны пользовательским данным: память нужна самому процессу, библиотекам и среде выполнения.
При отказе рабочего процесса NodeManager сообщает о состоянии. ApplicationMaster решает, какие задачи своего приложения повторить и какие ресурсы запросить снова. Общий ResourceManager не обязан понимать, какую группу обрабатывал reducer и какой файл нужно перечитать. Такое разделение позволяет одному RM обслуживать разные виды вычислений.
Очереди и распределение ресурсов
Кластер могут делить ежедневные загрузки и исследовательские запросы. Очереди помогают распределять ресурсы между такими группами. У очередей бывают ограничения и разрешения на использование свободных ресурсов соседей; конкретные правила задаёт администратор.
Очередь YARN не требует завершать одно приложение перед запуском следующего. Несколько приложений могут выполняться одновременно в выделенных им долях ресурсов. Важны ограничения очереди, допустимые размеры одного запроса и доступность узлов, а не только место приложения в списке.
Если приложение принято, но долго не запускает задачи, причина может быть в ожидании ресурсов. Запрос 8 GB не поместится на узле с доступными 4 GB. Два таких узла не превращаются для одного процесса в одну машину на 8 GB. Увеличение запроса памяти иногда делает ожидание длиннее, а не ускоряет задачу.
YARN и Kubernetes
Если Spark запускается в Kubernetes, ресурсы ему выделяет Kubernetes, а не YARN. Значит, YARN заменим как способ запуска поддерживающего такую работу приложения. Сам расчёт по-прежнему планирует driver Spark; HDFS тоже не обязан исчезать при смене менеджера ресурсов.
YARN удобен в существующей Hadoop-платформе: у команд уже есть очереди вычислений, правила доступа, журналы и приложения, умеющие запрашивать ресурсы через ApplicationMaster. Запросы могут учитывать расположение входных данных. Это практическое преимущество интеграции, а не утверждение, что YARN быстрее при любом расчёте.
Kubernetes управляет приложениями в контейнерах более общего назначения. При кластерном режиме запуска Spark размещает driver и executors в Pod; образы содержат необходимые зависимости. Но перенос требует настроить образы, права, сеть, доступ к данным, журналы и правила разделения ресурсов между командами. Очередь YARN и набор квот Kubernetes не тождественны: привычные гарантии планирования пакетных заданий нельзя считать перенесёнными автоматически.
Поэтому нельзя заменить слово yarn в настройке любого Hadoop-приложения и получить работающий запуск в Kubernetes. Сначала проверяют поддержку движка и способ его развёртывания. Для новой платформы выбирают подходящую среду; для существующей оценивают пользу переноса и стоимость изменений.
Что делает инженер данных
На подготовленном YARN-кластере приложение получает идентификатор вида application_.... Его удобно сохранить вместе с датой и входной поставкой. Для наблюдения доступны веб-интерфейс RM и команды:
yarn application -list
yarn application -status application_1234567890000_0001
yarn logs -applicationId application_1234567890000_0001
Здесь ID иллюстративный: подставьте значение своего запуска. Первая команда по умолчанию показывает активные приложения, вторая — состояние выбранного. Состояние ACCEPTED может означать ожидание запуска AM; RUNNING — работу приложения. В завершённом запуске проверяют и итоговый статус, например SUCCEEDED или FAILED.
yarn logs зависит от доступности журналов и настройки их сбора. В stderr ищут сообщение самой программы: неверную строку, отсутствующий Python, отказ доступа. После завершения сверяют входные файлы и результат расчёта.
Перед рабочим запуском инженер указывает вход и выход, выбирает разрешённую очередь, передаёт код и зависимости, задаёт ресурсы средствами своего движка. После запуска проверяет application ID, итоговое состояние, журнал программы и данные на выходе. Ошибка доступа к HDFS, ожидание ресурсов и неверная сумма в результате относятся к разным этапам — увеличение памяти не исправляет их все.
Наш локальный HDFS-стенд YARN не содержит. Эти команды относятся к рабочему или отдельно подготовленному учебному вычислительному кластеру.