В этой практике проследим один CSV: создадим локально, загрузим в HDFS, найдём его блок, изменим число копий и скачаем обратно. Используем уже запущенную лабораторию с тремя живыми DataNode. Небольшой файл выбран специально: его содержимое и размер можно проверить вручную, а правила хранения те же, что у большой поставки.
Сначала определяем, где работает команда
Из каталога лаборатории на компьютере откройте Bash в контейнере:
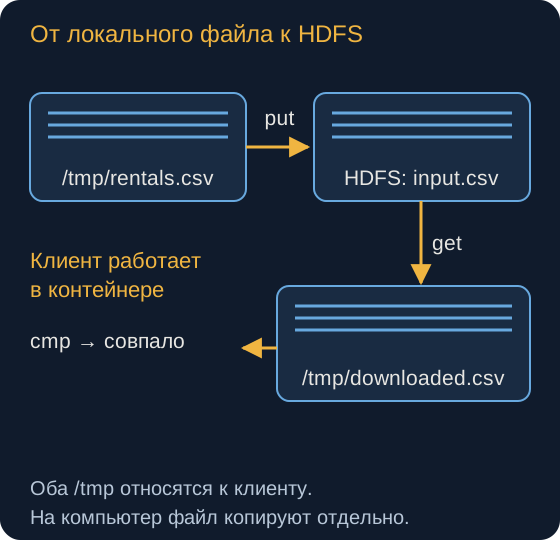
docker compose exec namenode bashДо раздела «Возвращаем файл на компьютер» команды выполняются в этой оболочке. Теперь локальный путь /tmp/rentals.csv относится к файловой системе контейнера. Путь /user/hadoop/rentals/input.csv в команде hdfs dfs относится к HDFS. Даже одинаковое написание /tmp у ls и hdfs dfs -ls означало бы разные места.
Создадим файл из четырёх строк:
printf 'rental_id,amount_rub\n1,100\n2,200\n3,200\n' > /tmp/rentals.csv
wc -c /tmp/rentals.csv
Получится 39 байт: заголовок, три записи и переводы строк. printf делает окончания строк предсказуемыми. Это поможет отличить изменение содержимого от проблемы передачи.
Загружаем и возвращаем байты
Создадим каталог в HDFS и загрузим файл:
hdfs dfs -mkdir -p /user/hadoop/rentals
hdfs dfs -put /tmp/rentals.csv /user/hadoop/rentals/input.csv
hdfs dfs -ls /user/hadoop/rentals
put читает локальный источник клиентского процесса и записывает поток в HDFS. Исходный файл в /tmp остаётся. В ls видны права, число реплик, владелец, группа, логический размер, время и путь. Повторный put в уже существующее имя без -f завершится ошибкой: повторная поставка не превращается автоматически в дописывание строк.
Прочитаем и скачаем результат:
hdfs dfs -cat /user/hadoop/rentals/input.csv
hdfs dfs -get /user/hadoop/rentals/input.csv /tmp/downloaded.csv
cmp /tmp/rentals.csv /tmp/downloaded.csv
cat должен показать те же четыре строки. get создаёт локальный файл внутри контейнера. При полном совпадении cmp ничего не выводит и возвращает код 0. Так мы проверяем содержимое, а не только наличие имени в каталоге.
Для повторного скачивания выберите новое локальное имя или осознанно используйте перезапись. Полезно сначала понимать, какой результат заменяется; -f не должен скрывать непредвиденный повтор запуска.
Смотрим на файл глазами HDFS
hdfs dfs -stat "bytes=%b replication=%r blocksize=%o" /user/hadoop/rentals/input.csv
hdfs dfs -du /user/hadoop/rentals/input.csv
hdfs dfs -count /user/hadoop/rentals
hdfs fsck /user/hadoop/rentals/input.csv -files -blocks -locations
stat для свежего файла нашей лаборатории ожидаемо покажет bytes=39 replication=3 blocksize=134217728: длину содержимого, заданный коэффициент и максимальный размер блока. Последнее число задаёт верхнюю границу блока. Для файла на 39 байт содержимое блока занимает 39 байт; фактические копии проверяют через fsck.
Для обычного реплицированного файла du показывает логический размер 39 и учитываемый объём с заданной репликацией 117 байт. Это не измерение каждого служебного байта на дисках и не доказательство наличия всех трёх исправных копий. Фактические расположения проверяем отдельно через fsck.
В выводе fsck ожидаем один блок длиной 39 байт и три расположения. Поле len=39 относится к содержимому блока, repl=3 — к найденным репликам. Три адреса после одного блока означают копии одних байтов, а не три отдельных CSV. Идентификаторы блоков и адреса будут отличаться между запусками.
Последний неполный блок не дополняется до заданного размера блока. Для файла на 700 MB блоков было бы шесть, но принцип чтения вывода тот же: у каждого свои длина и расположения. В сводке смотрите также потерянные и недореплицированные блоки.
fsck здесь используется для диагностики. Не добавляйте к нему опции, изменяющие файлы, в надежде «починить всё»: сначала надо понять, чего именно не хватает.
Меняем число копий
Для одного учебного файла попросим две реплики, дождёмся изменения и вернём три:
hdfs dfs -setrep -w 2 /user/hadoop/rentals/input.csv
hdfs fsck /user/hadoop/rentals/input.csv -files -blocks -locations
hdfs dfs -setrep -w 3 /user/hadoop/rentals/input.csv
hdfs fsck /user/hadoop/rentals/input.csv -files -blocks -locations
Флаг -w ждёт достижения нужного числа копий. Изменение не обязано быть мгновенным. Если живых DataNode только два, ожидание трёх реплик может продолжаться неопределённо долго. Ctrl+C прекращает ожидание клиента, но не обязательно отменяет уже заданный коэффициент.
Содержимое CSV от setrep не меняется. Меняются требования к размещению тех же байтов. И все копии нашего стенда всё ещё зависят от одного физического компьютера.
Меняем имя и доступ
hdfs dfs -mkdir -p /user/hadoop/published
hdfs dfs -mv /user/hadoop/rentals/input.csv /user/hadoop/published/rentals.csv
hdfs dfs -chmod 640 /user/hadoop/published/rentals.csv
hdfs dfs -ls /user/hadoop/published
mv внутри одной HDFS меняет пространство имён: не требуется скачивать файл на клиент и загружать заново. После перемещения старый путь больше не является адресом файла. 640 означает чтение и запись для владельца, чтение для группы и отсутствие прав для остальных. Чтобы пройти по каталогу, нужны соответствующие права на каталог, в частности x.
Эти права относятся к логическому файлу HDFS, а не к внутренним файлам блоков на дисках DataNode. В учебном режиме имя пользователя не даёт надёжной аутентификации; в защищённых кластерах используют Kerberos и связанные политики доступа, другие средства управления доступом.
Удаление и сохранённая локальная копия
Учебный CSV теперь лежит в /user/hadoop/published. Когда он больше не нужен в HDFS, удаление выглядит так:
hdfs dfs -rm /user/hadoop/published/rentals.csvРеплики не являются историей версий: удаление логического файла касается его хранения в HDFS. Возможность возврата через Trash зависит от fs.trash.interval; в лаборатории корзина специально не включена. Не рассчитывайте на неё. Флаг -skipTrash обходит корзину там, где она настроена, и здесь не нужен.
Возвращаем файл на компьютер
Локальный /tmp/downloaded.csv, созданный через get, сохранился независимо от удалённого HDFS-пути. Выполните exit, чтобы выйти из оболочки контейнера. Затем в терминале компьютера:
docker compose cp namenode:/tmp/downloaded.csv ./downloaded.csvТеперь файл появился рядом с compose.yaml. Получился полный маршрут: компьютер управляет контейнером → локальный файл клиента → HDFS → локальный файл клиента → компьютер.
| Команда | Что помнить |
|---|---|
hdfs dfs -put LOCAL HDFS | Источник локален именно клиентскому процессу |
hdfs dfs -get HDFS LOCAL | Результат создаётся рядом с клиентом, не обязательно на ноутбуке |
hdfs dfs -cp SRC DST | Копирование по файловым путям, обычно внутри HDFS |
hdfs dfs -du -h PATH | Размеры, включая учитываемую избыточность |
hdfs dfs -df -h / | Сведения о ёмкости файловой системы |
hdfs dfs -help put | Справка установленной версии |
cat удобен для наших 39 байт, но не для выгрузки на терабайты. Бинарный Parquet также не станет читаемой таблицей после cat: для просмотра нужен инструмент, который понимает формат.