Нужно посчитать, сколько раз каждое слово встречается во множестве документов. Один процесс может читать все файлы подряд, но большой набор удобнее разделить между работниками. Каждый умеет разобрать свою часть, а затем кто-то должен объединить сведения об одинаковых словах.
MapReduce — модель такой обработки и её реализация в Hadoop. Разработчик задаёт два основных действия: map создаёт промежуточные пары, reduce объединяет значения с одинаковым ключом. Система распределяет работу, передаёт данные и повторяет задачи при сбоях.
Аналогия с бургерами
На рисунке показаны несколько бургеров разного состава. Каждый бургер раскладывают на ингредиенты, затем одинаковые ингредиенты собирают вместе и подсчитывают. Разобрать каждый бургер можно независимо, но для общего количества сыра нужно объединить результаты всех разборов.
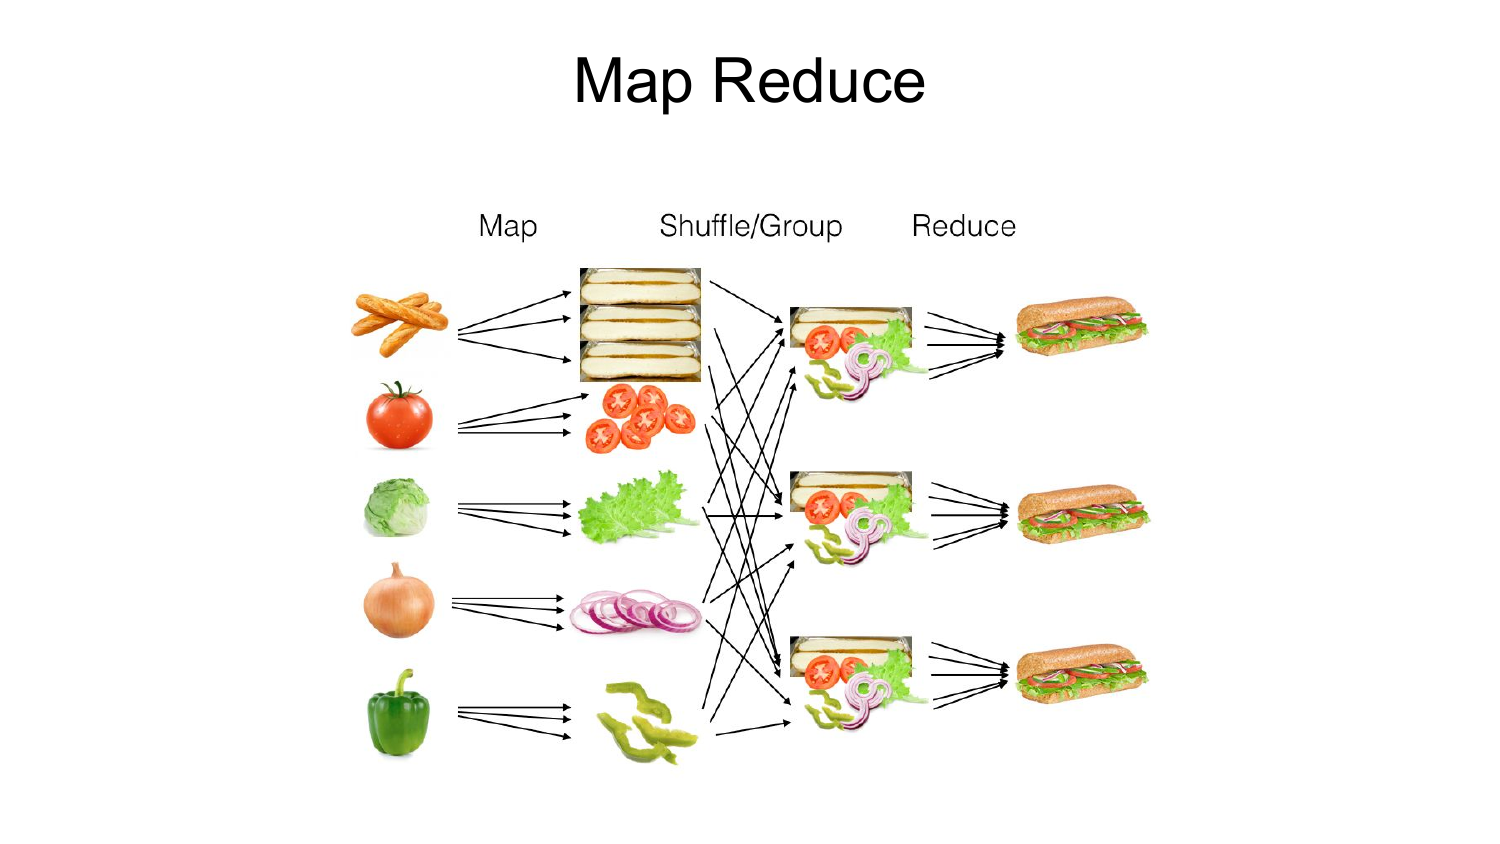
В программе этим действиям соответствует обработка записей: map создаёт пары, shuffle собирает одинаковые ключи, reduce объединяет значения.
Один расчёт по шагам
Пусть первый документ содержит кот спит, второй — кот ест. Для каждого слова mapper выдаёт пару (слово, 1):
Документ 1 → (кот, 1), (спит, 1)
Документ 2 → (кот, 1), (ест, 1)
Ключ определяет, какие результаты относятся к одной группе. Здесь ключом является слово. Значение — то, что нужно обработать внутри группы, здесь единица наблюдения.
Перед reducer система собирает значения одного ключа:
кот  → [1, 1] → 2
спит → [1]    → 1
ест  → [1]    → 1
Количество workers не меняет ответ: слово кот встретилось дважды. В других задачах ключом может быть дата, тип сообщения или имя источника, а значением — сумма, длительность или нужные поля события.
Что запускается один раз, а что много раз
Задание, job, — весь расчёт по заданному входу. Map task — работа над одной входной частью. Внутри неё функция map вызывается для отдельных записей. Одна запись может породить ноль пар, одну или много: пустую строку можно пропустить, а строку из трёх слов — превратить в три пары.
Reduce task обычно обрабатывает много ключей. Для каждого ключа вызывается логика reduce, которая получает только значения своей группы. Поэтому фраза «один reducer обрабатывает один ключ» неточна: один процесс может последовательно обработать десятки ключей, но все значения конкретного ключа должны встретиться вместе.
Это похоже на знакомые WHERE и GROUP BY только по смыслу результата. В SQL вы описываете запрос, а здесь явно выбираете промежуточный ключ и значение и задаёте функции обработки. Неверно выбранный ключ изменит группировку, даже если код без ошибок запустился на тысяче машин.
От файла к задачам
Вход делится на InputSplit, логические части работы для mapper. Это понятие вычислений; блок HDFS — понятие хранения. Размеры часто связаны, но равенство «один блок всегда один mapper» неверно: влияют формат, сжатие и настройки чтения.
Читатель входа превращает байты в записи. Для обычного текста записью обычно является строка. Если граница части попала в середину строки, читатель должен корректно обработать границу; mapper не должен самостоятельно склеивать куски сетевых пакетов.
TextInputFormat — стандартный способ читать текстовый вход построчно. Для обычного несжатого текста несколько частей большого файла можно обработать независимо. Но один файл .gz при таком чтении не разбивается между несколькими mapper: поток сжатия нельзя начать декодировать с произвольного места. Файл может занимать много блоков HDFS и всё равно стать работой для одного mapper. Здесь видно, почему число блоков не равно автоматически числу задач.
Это важно для CSV: многострочное поле в кавычках не становится одной записью только потому, что Python умеет его читать. Для такого входа нужен читатель, понимающий многострочные поля.
Где здесь HDFS и YARN
HDFS хранит входные и выходные файлы. YARN предоставляет ресурсы. MapReduce управляет вычислительными задачами своего приложения и их обменом. Это три разных роли, даже когда всё установлено на одних серверах.
Если работник упал, задачу можно запустить повторно. Поэтому mapper и reducer лучше строить как обработку входа с выводом результата, а не как произвольную отправку писем или независимые вставки во внешнюю базу. Повтор вычисления не должен случайно удвоить внешний эффект.
MapReduce особенно удобно объясняет пакетную обработку большого фиксированного набора. Цепочка из многих таких заданий требует промежуточного хранения и запуска новых этапов; это одна из причин появления более гибких вычислительных движков.