Сначала отфильтровать события, затем соединить их со справочником, сгруппировать и сохранить результат — обычная задача инженера данных. В MapReduce такую цепочку можно выразить несколькими заданиями, но разработчику приходится связывать их выходы и входы. Apache Spark позволяет описывать более богатый набор преобразований в одной программе и строит план их выполнения.
Spark — отдельный вычислительный фреймворк из той же области распределённой обработки. Он не является новой версией Hadoop или частью HDFS. При этом Spark умеет читать HDFS и получать ресурсы через YARN. Также возможны другие хранилища и способы запуска, включая локальный режим и Kubernetes.
Кто выполняет программу
В приложении Spark есть driver, управляющий процесс. В обычном приложении один активный driver: он создаёт план работы и координирует выполнение. Добавление executors не добавляет drivers. Executors — рабочие процессы этого приложения на узлах: выполняют задачи и хранят необходимые промежуточные данные.
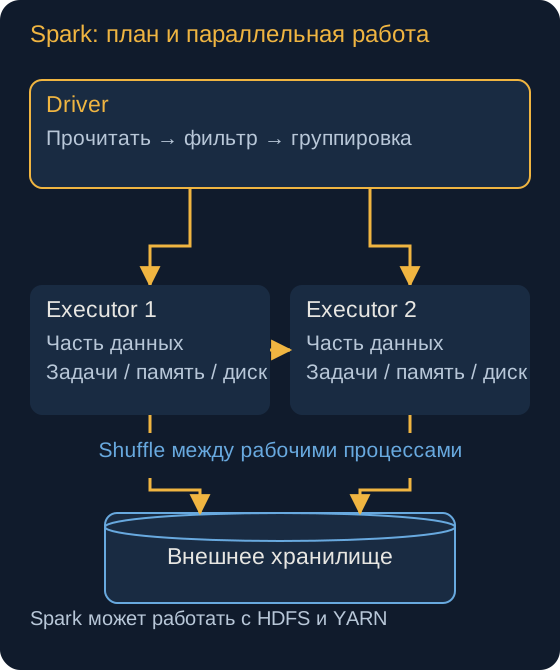
Набор данных разбивается на партиции, части для параллельной обработки. Небольшую единицу работы над частью данных называют task, задачей. Приложение запускает много tasks, а executors могут выполнять их последовательно и параллельно в пределах доступных ресурсов.
При запуске через YARN тот выделяет ресурсы. Driver Spark определяет вычислительную работу внутри приложения. Где находится driver — на клиентской машине или в кластере — зависит от режима запуска; это не нужно угадывать по месту хранения входного файла.
Код описывает последовательность преобразований
Для табличных данных Spark предоставляет DataFrame — распределённый набор строк с именованными колонками и схемой. К нему можно применять знакомые по SQL фильтры, выбор колонок, соединения и группировки. Интерфейс Python называется PySpark.
На более низком уровне есть RDD — распределённая коллекция элементов с преобразованиями и зависимостями, по которым Spark может восстановить потерянную часть расчёта. Элементами могут быть, например, пары ключ–значение. DataFrame добавляет схему и выражения, смысл которых понимает SQL-оптимизатор. Поэтому для таблиц обычно удобнее DataFrame: движок может выбрать колонки, перенести фильтры и подобрать план соединения. Произвольную функцию над элементами RDD он так же подробно проанализировать не может.
Например, программа читает журнал событий, оставляет строки с status = 'error', группирует их по имени сервиса и считает количество ошибок. Spark распределит обработку частей между executors. Группировка по сервису по-прежнему может требовать shuffle: одинаковые ключи нужно собрать вместе.
Преобразования обычно описываются лениво: вызов фильтра создаёт часть плана, а не обязательно немедленно читает весь набор. Действие, например запись результата, запускает вычисление. Это позволяет движку учитывать всю цепочку, а не выполнять каждый шаг отдельно без знания следующих.
Фильтр status = 'error' можно применить независимо к каждой входной партиции: для проверки строки не нужны остальные записи. А для полного GROUP BY service частичные результаты одного сервиса нужно объединить между партициями. Именно на таком обмене появляется граница этапов вычисления, stages.
Если у приложения два executor, а вход разбит на сто партиций, это не означает создание ста процессов. Executors выполняют множество небольших задач; число одновременно работающих зависит от ресурсов. И партиция Spark не является ни стойкой, ни репликой блока HDFS: это часть вычислительной работы, которая может меняться при преобразованиях.
Агрегация в PySpark
Когда для каждой группы нужны несколько показателей, их можно описать одним agg. Для обращения к Spark из Python используют SparkSession — объект, через который создают и читают DataFrame. Следующий пример предполагает уже созданную сессию с именем spark:
from pyspark.sql import functions as F

measurements = spark.createDataFrame(
    [("north", 10.0), ("north", 14.0), ("south", 9.0)],
    ["zone", "temperature"],
)
summary = measurements.groupBy("zone").agg(
    F.count("*").alias("readings"),
    F.avg("temperature").alias("mean_temperature"),
    F.sum(F.when(F.col("temperature") > 12, 1).otherwise(0)).alias("warm_readings"),
)
summary.show()
Для north получатся 2 измерения, среднее 12 и 1 значение выше 12; для south — 1, 9 и 0. Порядок строк без сортировки не задан. show() запускает расчёт; группировка собирает частичные результаты между партициями. Среднее нужно вычислять по всем значениям или через сумму и количество, а не как среднее локальных средних.
Файл, row group и партиция Spark
Parquet — двоичный колоночный формат файла. Внутри файл разбит на row groups, группы строк; в каждой группе значения одной колонки лежат отдельным фрагментом. Поэтому запрос может читать только нужные колонки. Метаданные и статистика позволяют пропускать некоторые группы, если по условию в них точно нет подходящих строк. Это не обещает, что любой фильтр полностью исключит ненужное чтение.
CSV хранит текстовые строки, а типы и правила разбора нужно согласовать отдельно. Parquet и ORC хранят типизированные колонки и удобны для аналитического чтения и сжатия. Выбор формата не заменяет выбор хранилища: один Parquet-файл может лежать в HDFS, S3 или локально.
Здесь важно различать три уровня:
| Уровень | Что разделяется |
|---|---|
| Блок HDFS | Байты файла для размещения и репликации |
| Row group Parquet | Строки внутри формата файла, сгруппированные по колонкам |
| Партиция Spark | Данные, которые обрабатывает одна задача данного этапа |
Число задач чтения нельзя получить, просто посчитав row groups. Spark планирует входные партиции с учётом размеров и делимости файлов, стоимости их открытия и настроек чтения, например spark.sql.files.maxPartitionBytes. Несколько маленьких файлов могут попасть в одну задачу, а крупный файл — в несколько. В планирование также вмешиваются отбор файлов и возможности источника. Для обычного этапа чтения одна task обрабатывает одну запланированную партицию; фактическое число смотрят в плане и Spark UI, а не выводят только из числа файлов, блоков или executors.
Repartition и coalesce
После сильной фильтрации может остаться много почти пустых партиций. DataFrame.coalesce(n) уменьшает их число, объединяя существующие части без нового shuffle. Увеличить число таким вызовом нельзя. repartition(n) перераспределяет строки через shuffle и позволяет как увеличить, так и уменьшить число частей; вариант с колонкой задаёт распределение по её значениям.
У RDD есть отдельный вариант coalesce(n, shuffle=True), который включает shuffle. У DataFrame.coalesce такого аргумента нет. Shuffle из предыдущего JOIN при этом никуда не исчезает: нужно различать сам вызов и полный план. Сведение результата в coalesce(1) может оставить работу одной задаче и резко уменьшить параллелизм.
Как Spark соединяет таблицы
INNER, LEFT, SEMI и ANTI описывают, какие строки должны попасть в результат. Физический алгоритм описывает, как их найти. Для соединения по равенству Spark может использовать сортировку и слияние, хеш-таблицу после перераспределения или рассылку небольшой стороны.
При типичном SortMergeJoin двух больших таблиц строки обеих сторон распределяются по ключу соединения, сортируются внутри получившихся частей и соединяются задачами. Записи одного ключа должны встретиться, даже если исходно лежали у разных executors. Такую зависимость от нескольких входных партиций называют широкой; обмен данными создаёт границу stages. Если нужное распределение и порядок уже обеспечены, часть этих действий может не понадобиться.
Другой вариант после перераспределения — ShuffledHashJoin: задача строит хеш-таблицу по своей части одной стороны и ищет в ней совпадения для строк другой. В отличие от сортировки и слияния, этот алгоритм требует, чтобы выбранная часть для хеш-таблицы помещалась в память.
При BroadcastHashJoin небольшую сторону превращают в хеш-таблицу и рассылают рабочим процессам. Тогда большую сторону не нужно перераспределять по сети ради этого соединения. Рассылка тоже имеет стоимость: копию нужно передать и разместить у executors. Для условий без равенства возможны другие алгоритмы, включая BroadcastNestedLoopJoin; у них могут быть совсем другие затраты.
Для broadcast оценивают размер стороны после фильтров и выбора колонок, её представление в памяти и допустимость выбранной стороны для типа JOIN. Сравнивают объём, а не только число строк: широкие строки и хеш-таблица могут занять много памяти. Если обе стороны велики, принудительная рассылка одной из них способна закончиться нехваткой памяти.
Оптимизатор учитывает условие соединения, тип JOIN, статистику размеров, настройки и подсказки. SortMergeJoin может появиться потому, что оценка превышает порог broadcast, статистика неполная, рассылка отключена либо стратегия не подходит данному соединению. Подсказка broadcast не исправляет неверную оценку памяти. AQE, адаптивное выполнение, может изменить часть плана по фактической статистике во время расчёта.
Если JOIN выполняется долго
Начинают с result.explain("formatted") и вкладок SQL и Stages в Spark UI. План показывает алгоритм и обмены, а метрики — сколько данных прочитано и передано, как долго работали tasks и сколько промежуточных данных ушло на диск.
Если медленны все задачи, проверяют объём чтения, ненужные колонки и фильтры, число партиций и общий объём shuffle. Если почти все закончились быстро, а одна или несколько продолжают работать, сравнивают размеры их входов. Частая причина — skew, перекос: очень популярный ключ сосредоточил большую часть данных в одной задаче. Простое увеличение числа партиций не делит один ключ равномерно. Помочь могут предварительная агрегация, отдельная обработка частых ключей и обработка перекоса средствами AQE — с проверкой смысла результата.
Другая причина — размножение строк: если одному ключу соответствуют 100 строк слева и 200 справа, этот ключ даст 20 000 сочетаний. Дополнительная память не исправит ошибочное условие JOIN. Сначала проверяют ключ и ожидаемую кратность, затем выбирают способ ускорения.
Чем Spark отличается от MapReduce
В Hadoop MapReduce одно задание имеет фиксированную форму: map, обмен промежуточными данными и reduce, если он нужен. Для более длинного расчёта обычно связывают несколько заданий через их файловые результаты. Каждое задание требует подготовки и запуска; промежуточные наборы приходится записывать и читать снова.
Spark строит граф операций одной программы. Последовательные преобразования без обмена между частями могут выполняться в одном этапе, а executors живут дольше отдельной задачи. При повторном использовании набора его можно кешировать — сохранить вычисленное представление для следующих обращений. Это особенно полезно для нескольких запросов к одному входу и итеративных алгоритмов, которые многократно обрабатывают те же данные.
Поэтому Spark во многих аналитических задачах занял место вычислительного движка MapReduce. При этом HDFS может остаться хранилищем, а YARN — распределять ресурсы. Замена вычислительного движка не требует автоматически заменять всю Hadoop-платформу. MapReduce продолжает использоваться в существующих пакетных заданиях. Скорость расчёта Spark зависит от объёма обмена, структуры данных и ресурсов.
Память, диск и промежуточные данные
Spark умеет повторно использовать сохранённые промежуточные данные, в том числе в памяти. Это полезно, если один набор нужен нескольким расчётам. Но утверждение «Spark всегда держит всё в RAM» неверно. Вход и результат остаются во внешнем хранилище, shuffle использует сеть и диск, а кеш зависит от выбранного режима и доступного места.
Cache и persist
Если один дорогой промежуточный DataFrame нужен нескольким действиям, cache() помечает его для повторного использования. Сам вызов не вычисляет все строки: кеш заполняется по мере выполнения действий. persist(...) позволяет явно выбрать уровень хранения. У DataFrame режим по умолчанию допускает память и диск; у RDD значения по умолчанию отличаются, поэтому нельзя считать любой cache() обещанием «только RAM».
Кешированные части находятся у executors. Потерянную часть при доступном исходном наборе можно пересчитать по зависимостям; кеш не является долговечным хранилищем результата. После последнего использования unpersist() освобождает сохранённые части. Кешировать всё подряд вредно: запись кеша стоит времени и отнимает память у вычислений. Особенно полезен набор, который дорого получить и действительно будут читать повторно.
Куда уходит память executor
Память executor нужна не только строкам входного файла. Executor выполняется в JVM, виртуальной машине Java. В её куче — области памяти для объектов — есть общая область для вычислений — сортировок, JOIN, агрегирования — и хранения кеша. Её размер регулирует spark.memory.fraction; spark.memory.storageFraction задаёт защищённую от вытеснения вычислениями долю хранения внутри этой области. Это не жёсткое деление всей памяти пополам: свободное место может использовать другая сторона. Остальная куча нужна пользовательским объектам и служебным структурам.
spark.executor.memory задаёт размер кучи JVM. Поверх неё нужен запас для других расходов процесса; на YARN и Kubernetes его учитывает spark.executor.memoryOverhead. Python workers тоже потребляют память вне JVM: отдельный бюджет spark.executor.pyspark.memory, если задан, учитывают дополнительно. Это объясняет, почему запросить «4 GB executor» и ожидать ровно 4 GB суммарного расхода нельзя. Лимиты задают при запуске приложения, а не надеются изменить уже выделенную память обычным преобразованием DataFrame.
Когда промежуточные структуры не помещаются в отведённую память, поддерживающие это операции выгружают часть данных на диск — spill. Это способ завершить расчёт с ограниченной RAM, а не обязательная ошибка. Однако чтение и запись диска могут замедлять задачу. Большой spill вместе с перекосом часто означает слишком тяжёлую партицию; увеличение памяти каждого executor без проверки распределения может лишь отложить проблему.
Большой результат нельзя бездумно собирать в driver: распределённая обработка потеряет смысл, если одна машина должна вместить все строки. Повторение задач и восстановление вычислений также не заменяют резервные копии исходных файлов.
Встроенные функции и UDF
Для проверки строки можно написать обычную Python-функцию и зарегистрировать её как UDF, пользовательскую функцию Spark. Она нужна, когда выражение нельзя удобно описать встроенными средствами. Но Spark хуже видит смысл произвольного Python-кода: не может свободно преобразовывать его внутренние условия как SQL-выражения. Передача значений между JVM и Python также стоит времени.
Поэтому сначала ищут встроенные функции для строк, дат и условий. Когда нужна UDF, задают возвращаемый тип, обрабатывают None и проверяют крайние значения. Нельзя рассчитывать, что внешнее условие всегда защитит UDF от вызова на неподходящей строке: оптимизатор может менять порядок вычислений. Векторизованные Pandas UDF и Arrow уменьшают некоторые затраты передачи, но не делают произвольный код прозрачным для оптимизатора.
UDF не должна изменять внешние данные или записывать строку во внешнюю систему «ровно один раз»: задачи могут повторяться, а вычисление функции — переупорядочиваться. Побочные действия требуют отдельного протокола повторов.
Spark выполняет преобразования, система управления кластером выделяет ему процессы и ресурсы, а хранилище сохраняет вход и результат. Такое разделение позволяет одному движку работать с разными платформами хранения и запуска.