В HDFS появился каталог с Parquet-файлами. Аналитик хочет написать SELECT, а не искать файлы вручную. Другому приложению нужно быстро получить конкретную запись по идентификатору. Хранилище байтов общее, но требования к работе с ними разные.
Hive: SQL поверх больших наборов
Apache Hive предоставляет SQL и табличное представление данных для аналитической обработки. Таблица связывается с местом хранения, форматом и схемой колонок. Hive разбирает запрос и организует его выполнение через вычислительный движок; в Hadoop-платформах часто используется Tez, который исполняет граф задач через YARN.
Metastore — каталог метаданных таблиц: имён, колонок, расположений и партиций. Его служебные записи обычно хранятся в отдельной реляционной базе. Сами большие файлы таблиц остаются в HDFS или другом поддерживаемом хранилище.
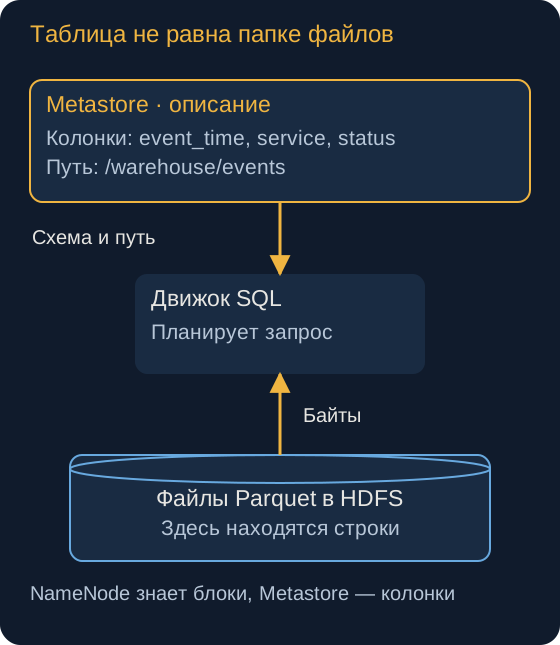
Важно не спутать два каталога. NameNode знает, из каких блоков состоит файл. Metastore знает, что каталог файлов соответствует таблице с колонками event_time, service, status. Это сведения о разных уровнях системы.
Что происходит после SELECT
Пользователь отправляет SQL сервису Hive, обычно через HiveServer2. Hive получает из Metastore схему таблицы, формат, путь и сведения о частях набора. Затем строит план: какие файлы прочитать, какие колонки нужны, где применить фильтр и как объединить результаты. Вычислительные задачи исполняются выбранным движком; при работе через YARN они получают ресурсы у него.
Читатель Parquet извлекает нужные поля из файлов, HDFS доставляет их байты, а задачи выполняют выражения SQL. Metastore не пересылает каждую строку запроса через свою служебную базу. Поэтому доступный каталог и успешный SHOW TABLES ещё не доказывают, что файлы на месте и пользователь имеет право их читать.
Партиционирование таблиц Hive
Партиционирование делит таблицу на части по значениям выбранных колонок. Например, журнал событий можно разделить по дню: данные каждого дня лежат в своём каталоге. Таблица остаётся одной, но запросу за конкретную дату не приходится читать весь архив.
Небольшой пример определения показывает отдельно поля записи и поле разделения:
CREATE EXTERNAL TABLE events (
    event_time TIMESTAMP,
    service STRING,
    status STRING
)
PARTITIONED BY (day STRING)
STORED AS PARQUET
LOCATION '/warehouse/events';
PARTITIONED BY объявляет ключ партиции day; его не нужно повторять среди обычных колонок. LOCATION задаёт корень хранения, STORED AS PARQUET — формат файлов. Это описание таблицы, а не загрузка или преобразование данных.
Типичное размещение файлов выглядит так:
/warehouse/events/
  day=2026-10-05/
    part-00000.parquet
  day=2026-10-06/
    part-00000.parquet
    part-00001.parquet
Одна партиция может содержать несколько файлов, каждый файл — несколько блоков HDFS. Дата задаёт логическое разделение записей; блоки определяют физическое размещение байтов по DataNode. Это разные уровни.
Metastore должен знать о партициях. Если каталог с готовыми корректными файлами добавлен вне Hive, регистрацию можно выразить отдельной операцией:
ALTER TABLE events ADD PARTITION (day='2026-10-06')
LOCATION '/warehouse/events/day=2026-10-06';

SELECT service, count(*) AS errors
FROM events
WHERE day = '2026-10-06' AND status = 'error'
GROUP BY service;
Это иллюстрация для уже существующих Parquet-файлов с указанной схемой. Ни CREATE, ни ADD PARTITION не создают события и не превращают CSV в Parquet. Соответствие дат внутри записей имени каталога проверяет процесс загрузки.
Условие по day позволяет исключить ненужные партиции до чтения файлов — это partition pruning. Условие только по status не задаёт день: соответствующие события могут находиться во всём архиве. Поэтому ключ разделения выбирают под частые фильтры и объём данных. Почти уникальный идентификатор часто даёт множество крошечных партиций и возвращает проблему малых файлов.
Партиция Hive хранится как часть таблицы. Партиция Spark — часть набора для вычислительных задач, которая может измениться после shuffle. Partitioner MapReduce направляет промежуточные ключи к reducer. У этих трёх механизмов разные единицы разделения.
Внешние и управляемые таблицы
Внешняя таблица, EXTERNAL, описывает данные, жизнью которых могут управлять другие процессы. У управляемой таблицы Hive отвечает и за их жизненный цикл. Поведение удаления зависит от типа таблицы, версии и свойств; перед удалением таблицы нельзя считать её файлы гарантированно сохранёнными только по привычке.
Один каталог Metastore могут использовать разные движки, если совместимы формат и настройки. Например, Spark записывает подготовленные данные, а аналитики обращаются к ним через SQL. Для общего чтения согласуют пути, форматы и схемы таблиц.
HBase: обращение по ключу
Apache HBase — распределённая база для больших таблиц с доступом к строкам по ключу. Например, сервису нужна последняя информация об устройстве sensor-204, а не полный подсчёт по всем устройствам за месяц. Такой сценарий отличается от массового аналитического сканирования.
У HBase есть ключ строки, row key. Диапазоны ключей обслуживаются частями таблицы — регионами — на RegionServer. В типичной Hadoop-установке файлы HBase хранятся в HDFS, но приложения обращаются к HBase через её интерфейс, а не редактируют эти файлы вручную.
Выбор ключа влияет на распределение нагрузки. Если все новые записи направлены в один край диапазона, часть серверов может быть перегружена. HBase не ускоряет произвольный SQL JOIN автоматически и не является другим названием Hive.
Например, ключ sensor-204 указывает на строку устройства, а колонка state:temperature — на показатель в семействе state. Семейство колонок задаётся заранее; конкретные колонки внутри него могут различаться у строк. HBase хранит значения ячеек с версиями. Запрос по известному row key находит обслуживающий его регион, а не запускает полный аналитический проход по всем HDFS-файлам.
Это объясняет, как HBase может обновлять данные, хотя HDFS не разрешает произвольно менять байты в середине готового файла: база организует собственные журналы, буферы и новые файлы хранения. Она предоставляет приложению операции над строками и сама управляет нижележащими файлами. Не нужно пытаться сделать то же самое командой hdfs dfs -put для каждой изменённой ячейки.
| Задача | Подходящая роль |
|---|---|
| Хранить большие файлы | HDFS |
| Описать колонки и расположение таблицы | Metastore |
| Выполнить аналитический SQL по набору | Hive с вычислительным движком |
| Выполнить программу преобразования | Spark или MapReduce |
| Читать и менять строки по ключу | HBase |
В одной платформе эти инструменты могут сосуществовать. Выбирать их полезнее по действию над данными, чем по длине списка компонентов.