В CSV шесть записей с ключом, числовым значением и статусом. Нужно выбрать записи со статусом valid и для каждого ключа посчитать сумму значений и количество записей. Hadoop Streaming позволяет использовать обычные программы, читающие стандартный ввод и пишущие стандартный вывод, как mapper и reducer. Здесь слово Streaming означает обмен потоками текста между процессами; это пакетный расчёт, а не непрерывная обработка событий.
Подготовим маленький вход
Создайте отдельную папку для примера. Сохраните приведённые ниже CSV и Python-скрипты в файлы records.csv, mapper.py и reducer.py в этой папке. Для локальной части нужны Python 3 и Bash, например Ubuntu в WSL 2.
record_id,group,value,status
r1,A,100,valid
r2,B,250,valid
r3,A,50,skip
r4,A,300,valid
r5,B,150,valid
r6,C,80,valid
Данные синтетические. Одна запись занимает одну строку; value — неотрицательное целое число, статусы — valid или skip. Идентификаторы записей уникальны. Поле group задаёт ключ группировки и не содержит табуляции и переводов строк: табуляция понадобится как разделитель промежуточных полей.
Сохраните следующие два скрипта рядом с CSV.
"""Emit key, sum and count for valid records. Input: strict CSV records."""
import csv
import sys

HEADER = ["record_id", "group", "value", "status"]


def main():
    for line_number, row in enumerate(csv.reader(sys.stdin, strict=True), 1):
        if row == HEADER:
            continue
        if len(row) != 4:
            raise ValueError(f"record {line_number}: expected four fields")
        record_id, group, value_text, status = row
        if not record_id or not group or any(c in group for c in "\t\r\n"):
            raise ValueError(f"record {line_number}: invalid identifier or group")
        if status not in {"valid", "skip"}:
            raise ValueError(f"record {line_number}: unknown status")
        value = int(value_text)
        if value < 0:
            raise ValueError(f"record {line_number}: negative value")
        if status == "valid":
            print(f"{group}\t{value}\t1")


if __name__ == "__main__":
main()"""Sum consecutive key groups. Also usable as an associative combiner."""
import sys
def main():
current = None
total = count = 0
for line in sys.stdin:
key, value_text, count_text = line.rstrip("\n").split("\t")
value, records = int(value_text), int(count_text)
if not key or value < 0 or records < 1:
raise ValueError("invalid intermediate record")
if current is not None and key != current:
print(f"{current}\t{total}\t{count}")
total = count = 0
current = key
total += value
count += records
if current is not None:
print(f"{current}\t{total}\t{count}")
if __name__ == "__main__":
main()Посмотрим между шагами
Откройте mapper.py: он читает CSV, узнаёт заголовок по точному совпадению полей, проверяет записи и пропускает записи со статусом skip. Для каждой записи со статусом valid выводит ключ, значение и число 1 через табуляцию. Если структура, значение или статус неверны, завершает работу с ошибкой.
python3 mapper.py < records.csvОжидаются пять строк: A 100 1, B 250 1, A 300 1, B 150 1, C 80 1. Запись r3 со значением 50 исключена по статусу, поэтому общая сумма будет 880, а не 930.
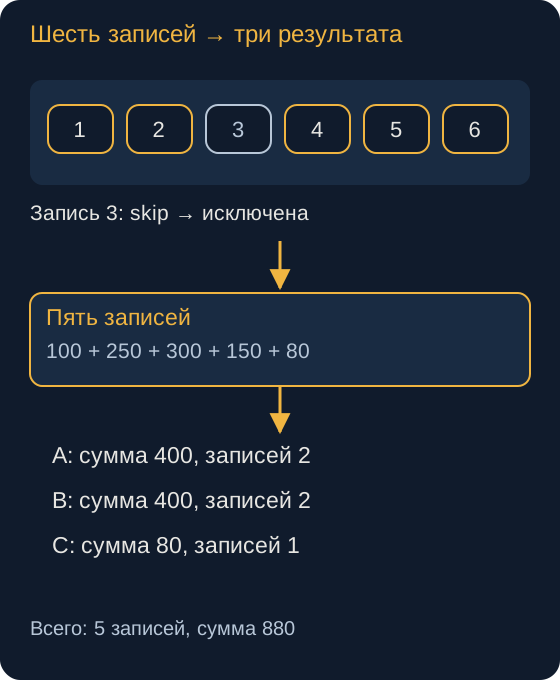
reducer.py ожидает соседние строки одного ключа. Он хранит текущий ключ, сумму и количество, печатает группу при смене ключа и обязательно печатает последнюю группу после конца входа. Все строки группы в список не накапливает. Складывает переданные количества, а не просто число строк, поэтому пригоден и для частичных результатов combiner.
Воспроизведём группировку локально
Создайте эталон expected.tsv с табуляцией между полями:
printf 'A\t400\t2\nB\t400\t2\nC\t80\t1\n' > expected.tsvset -o pipefail
python3 mapper.py < records.csv |
LC_ALL=C sort -t $'\t' -k1,1 |
python3 reducer.py > actual.tsv
diff -u expected.tsv actual.tsvsort ставит одинаковые ключи рядом. pipefail не позволяет ошибке mapper скрыться за успешным завершением последней команды. Пустой вывод diff означает совпадение с эталоном:
A  400  2
B  400  2
C   80  1
В файле разделителем служит табуляция. Всего учтено пять записей, сумма значений — 880. Это проверка логики на одном компьютере, без сети и распределения задач. Уникальность record_id скрипты глобально не проверяют: дубль записи увеличил бы результат, поэтому она остаётся требованием к входу.
Та же логика на подготовленном кластере
Команды ниже требуют Hadoop 3.4.3 с настроенными HDFS, YARN и MapReduce, Python 3 на вычислительных узлах и доступного пользователю каталога /user/learner. Наш Docker-стенд HDFS этих вычислительных служб не содержит. Каталоги примера предполагаются новыми.
hdfs dfs -mkdir -p /user/learner/records-input
hdfs dfs -put records.csv /user/learner/records-input/records.csv
mapred streaming \
  -D mapreduce.job.name=RecordsByKey \
  -D mapreduce.job.reduces=2 \
  -files mapper.py,reducer.py \
  -input /user/learner/records-input/records.csv \
  -output /user/learner/records-mr-run-01 \
  -mapper 'python3 mapper.py' \
  -combiner 'python3 reducer.py' \
  -reducer 'python3 reducer.py'
Hadoop Streaming разделяет вывод mapper по первой табуляции: до неё ключ group, после неё значение из суммы и количества. Поэтому отладочные сообщения нельзя печатать в stdout рядом с данными — они попадут в shuffle как дополнительные записи. Для сообщений программы предназначен stderr, который затем читают в журнале задачи.
-files доставляет скрипты, но не устанавливает Python. -D задаёт параметры задания. Два reducer делят ключи; это не обещание двух mapper для маленького входного файла. Сохраните application ID, выданный запуском.
После успешного завершения сравните результат:
hdfs dfs -cat '/user/learner/records-mr-run-01/part-*' |
  LC_ALL=C sort -t $'\t' -k1,1 > cluster.tsv
diff -u expected.tsv cluster.tsv
Разные ключи могут оказаться в разных файлах, одинаковый ключ при стандартном разделении направляется одному reducer. Сортируем объединённый вывод только для сравнения с эталоном. Для повторного расчёта выберите новый выходной каталог, например records-mr-run-02. Если задание упало, сообщение Python в журнале полезнее случайной смены объёма памяти.