Mapper одного узла выдал для ключа A значения 100 и 300, а mapper другого — ещё 50. Общий ответ 450 получится, только если результаты встретятся в одной группе. Локальной суммы первого процесса недостаточно.
Передача промежуточных данных от mapper к нужным reducer называется shuffle. Вместе с сортировкой и группировкой она подготавливает вход reducer: одинаковые ключи идут вместе, независимо от того, где они появились.
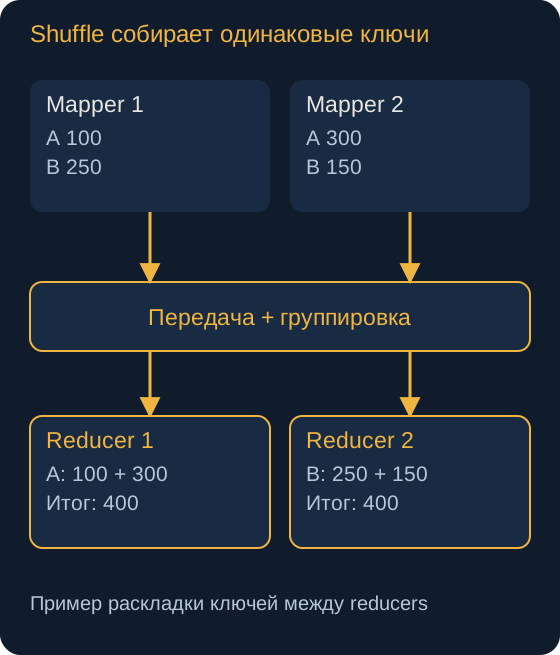
Кто выбирает получателя
Partitioner определяет, какому reducer отправить пару. Обычно это правило на основе хеша ключа и числа reducers. При обычной настройке один и тот же ключ направляется одному reducer. Разные ключи могут попасть к одному получателю — отдельный процесс для каждого ключа не создаётся.
Сортировка упорядочивает входные ключи в части, доставшейся reducer. Сам reducer может выдавать любые ключи и строки: его выход повторно не сортируется. Поэтому ни общий порядок нескольких файлов, ни произвольный результат reducer нельзя считать отсортированным автоматически. На выходе обычно получается каталог с файлами part-r-..., по одному на reducer, а не один автоматически объединённый CSV.
Если почти все записи имеют один и тот же ключ, этот ключ создаёт большую группу. Один reducer получает намного больше работы, чем остальные. Такой перекос называют skew. Добавление reducers само по себе не разбивает один и тот же ключ между ними.
Что физически происходит между map и reduce
Представим два mapper и два reducer. Договоримся, что partitioner направляет A и C в R0, B — в R1; это иллюстрация распределения, а не обещание конкретного результата встроенной хеш-функции.
| Где появилась пара | Часть для R0 | Часть для R1 |
|---|---|---|
| M0 | (A, 100), (C, 80) | (B, 250) |
| M1 | (A, 300) | (B, 150) |
Каждый mapper буферизует пары, распределяет их по получателям и сортирует. Когда буфер заполняется, промежуточные данные выгружаются на локальный диск; ждать, пока весь результат поместится в RAM, не требуется.
Выгрузка промежуточных данных из памяти на диск называется spill. Она позволяет обрабатывать набор больше RAM, хотя дополнительные обращения к диску стоят времени. Например, массив 32 GB при 8 GB RAM можно сортировать порциями: прочитать помещающуюся часть, отсортировать и записать её, затем слить отсортированные части, держа в памяти только буферы. Размер порции выбирают меньше всей RAM — память нужна и программе. Это внешняя сортировка; для неё не обязательно запускать распределённый кластер.
R0 забирает свою часть от обоих mapper, а R1 — свою. Полученные отсортированные части сливаются: R0 увидит рядом A: 100, 300, затем C: 80; R1 увидит B: 250, 150. Для каждой группы вызывается reduce. Передача и слияние могут начинаться по мере готовности результатов mapper, а не только после завершения последнего из них.
Поэтому shuffle — заметная работа с сетью, памятью и диском. Для большой группировки объём промежуточных данных может оказаться важнее скорости самой операции сложения.
Как уменьшить передачу
Для суммы mapper может предварительно объединить собственные значения:
Без объединения: (A, 100), (A, 300)
После объединения: (A, 400)
Такое локальное предварительное объединение называется combiner. В примере вместо двух записей достаточно передать одну. Но combiner видит только доступную ему часть данных, а не все значения данного ключа.
Hadoop может вызвать combiner ноль, один или несколько раз. Правильный ответ не должен зависеть от его запуска. Поэтому частичный результат должен иметь форму, которую следующий шаг умеет объединять снова. Сложение сумм этому условию соответствует.
Почему нельзя просто усреднять средние
У первого mapper значения 2, 4, среднее 3. У второго одно значение 5, среднее 5. Среднее двух средних равно 4, но среднее трёх исходных значений — 11 / 3, примерно 3,67. Группы имели разный размер, а мы придали им одинаковый вес.
Передавайте пару сумма и количество. Первая часть даст (6, 2), вторая (5, 1). Их можно сложить в (11, 3) и разделить только после окончательного объединения. Reducer, который получает и складывает такие пары, может использоваться и как combiner. Деление выполняют отдельно после объединения всех частичных результатов.
Что происходит при сбое и завершении
Промежуточный результат mapper обычно хранится на локальном диске вычислительного узла. Он не становится автоматически файлом HDFS с тремя репликами. При потере узла систему может выручить повтор mapper, который заново прочитает вход.
Для обычного файлового вывода MapReduce отделяет временный результат попытки от принятого результата задания. Однако произвольная запись вашей программы во внешнюю базу не получает такую защиту автоматически. Её устойчивость к повторам приходится обеспечивать отдельно.
Выходной каталог нового задания обычно не должен уже существовать. Это помогает не смешать старые файлы с новым расчётом. После успеха нужно проверить и данные: наличие _SUCCESS сообщает о завершении задания, но не заменяет ожидаемое число строк и контрольную сумму показателя.