Мы знаем роли HDFS; теперь соберём среду, где можно увидеть их работу. Один контейнер будет хранить карту файлов, ещё три — блоки. Затем загрузим небольшой файл и проверим, что у его блока есть три расположения. Для этого не нужны четыре физических сервера: все процессы поместятся на учебном компьютере.
Что именно запускаем
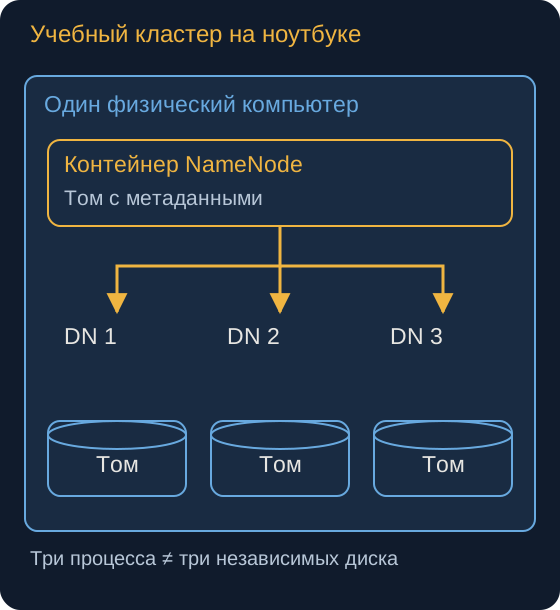
В архиве лаборатории один образ Hadoop 3.4.3 с Java 11. Из него Compose создаёт четыре контейнера: namenode, datanode1, datanode2 и datanode3. Стартовая команда выбирает роль процесса. У каждого DataNode свой том блоков, у NameNode — свой том метаданных.
Это прямое применение Docker: образ содержит установленную программу, контейнер выполняет роль, сеть соединяет роли по именам, том сохраняет состояние. YARN и Spark здесь не запускаются — для наблюдения за записью и чтением HDFS они не нужны.
Все четыре контейнера используют один компьютер. Остановка одного DataNode моделирует отказ процесса. Физические диски, питание и компьютер у всех экземпляров общие. В лаборатории также нет HA NameNode и Kerberos. Её порты и учебные данные не предназначены для публикации в интернет.
Подготовка каталога
Понадобятся работающие Docker Engine и Compose, интернет для первой сборки и свободные ресурсы. Практический ориентир — около 4 GB доступной Docker памяти и 10 GB диска с запасом на слои и загрузку. На Windows используйте терминал Ubuntu в WSL 2. Если рядом работают другие тяжёлые стенды, памяти может потребоваться больше.
Скачайте архив HDFS-лаборатории, распакуйте в отдельный каталог и откройте там терминал. В текущем каталоге должен быть compose.yaml:
hdfs-lab/
  compose.yaml
  Dockerfile
  start.sh
  conf/
    core-site.xml
    hdfs-site.xml
Dockerfile выбирает архив Hadoop для AMD64 или ARM64, загружает его и сверяет опубликованную SHA-512. Проверка суммы помогает обнаружить повреждённую загрузку. Java и Hadoop выбраны совместно; заменять Java на случайную более новую версию без проверки совместимости не стоит.
От описания к живым узлам
Выполните по очереди:
docker compose config --quiet
docker compose build
docker compose up -d --wait --wait-timeout 180
docker compose ps
Первая команда проверяет, что Compose понимает описание. build создаёт образ; первая загрузка Hadoop может занять время. up создаёт сеть, тома и контейнеры и ждёт заданных healthcheck.
Теперь спросим саму HDFS:
docker compose exec namenode hadoop version
docker compose exec namenode hdfs dfsadmin -report
Версия должна соответствовать лаборатории, а отчёт — содержать Live datanodes (3). В нём также видны ёмкость, использованное место и сведения об узлах. Именно регистрация трёх DataNode подтверждает, что NameNode их видит. Открытый порт или статус контейнера running этого не гарантируют.
Если живых узлов меньше трёх, сначала посмотрите:
docker compose logs --tail 100
docker compose exec namenode hdfs dfsadmin -safemode get
В начале запуска NameNode может находиться в safe mode: собирает сведения о блоках и ограничивает изменения. Не начинайте с принудительного выхода. Проверьте ошибки запуска DataNode, доступность сети и сохранность томов. После регистрации узлов и нормального выхода из safe mode можно загружать данные.
Два адреса одной системы
Веб-интерфейс NameNode доступен по http://localhost:19870. Compose публикует внутренний веб-порт 9870 на порт компьютера 19870. В браузере можно посмотреть сведения о кластере и DataNode.
Клиент HDFS использует другой интерфейс — RPC по адресу hdfs://namenode:9000 внутри сети Compose. Число 9000 не надо подставлять в браузер вместо веб-порта. При чтении клиент также соединяется с DataNode, чьи внутренние адреса возвращает NameNode.
Поэтому учебные команды выполняем через docker compose exec namenode: клиент попадает в общую сеть и видит имена узлов. Веб-скачивание может перенаправить браузер на внутренний адрес DataNode, недоступный с компьютера. Для практики передачи файлов используем CLI.
Первый запуск и сохранение состояния
При первом старте скрипт проверяет /data/name. Пустой каталог ещё не содержит пространства имён, поэтому выполняется начальное форматирование. Если существует current/VERSION, повторное форматирование пропускается. Непустой каталог без ожидаемых метаданных приводит к остановке: скрипт не пытается молча создать новый кластер поверх неизвестного состояния.
hdfs namenode -format создаёт пространство имён. Это не команда ремонта потерянных файлов. Сохранить тома DataNode, а карту NameNode заменить новой — не способ восстановить прежние пути.
Для обычной остановки и возвращения к работе:
docker compose down
docker compose up -d --wait --wait-timeout 180
docker compose exec namenode hdfs dfsadmin -report
Без флага удаления томов данные остаются в именованных томах. После запуска проверьте не только три живых узла, но и нужные файлы. Полный сброс стенда выполняется командой docker compose down --volumes: она намеренно удаляет и карту, и блоки из томов лаборатории. Используйте её только когда результаты больше не нужны.