Файл лежит на компьютере загрузчика. После hdfs dfs -put он должен появиться в общем каталоге HDFS и остаться доступным, даже если один сервер хранения перестанет отвечать. Посмотрим, кто выполняет каждое действие. Клиентом здесь называется программа загрузки с библиотекой HDFS: именно она читает локальный файл и ведёт обмен с кластером.
Возьмём events.csv размером 250 MB. Для арифметики договоримся о блоках по 100 MB и трёх репликах; это условные настройки примера, не значения по умолчанию. Получатся A на 100 MB, B на 100 MB и C на 50 MB. Внутри HDFS нет трёх CSV с независимыми заголовками: есть три последовательных диапазона байтов одного файла.
1. Клиент открывает файл для записи
Клиент обращается к NameNode: создать /logs/day-01/events.csv. NameNode проверяет путь, права и возможность создания файла. Например, загрузка в существующее имя без разрешения перезаписи должна закончиться ошибкой. NameNode добавляет сведения о создаваемом файле в пространство имён и фиксирует изменение метаданных.
Файл пока находится в состоянии записи. В каждый момент у HDFS-файла один писатель; несколько процессов не могут независимо менять его середину, как строки общей таблицы. Клиент поддерживает право продолжать запись, пока работает с файлом. Это нужно, чтобы кластер отличал активного писателя от оборвавшейся загрузки.
Содержимое CSV на этом шаге не отправляется NameNode. Служба метаданных определяет, куда его можно записать; сами байты будут принимать DataNode.
2. Для блока выбираются узлы и строится цепочка
Когда клиенту нужен первый блок, он запрашивает его размещение. NameNode выбирает DataNode с учётом доступности, места и правил расположения реплик. Допустим, он вернул dn1, dn2, dn3.
Клиент соединяется с dn1 и передаёт сведения о следующих участниках. dn1 соединяется с dn2, тот — с dn3. Получилась цепочка записи, или pipeline:
Клиент → dn1 → dn2 → dn3Каждый DataNode сохраняет свою копию одних и тех же байтов блока A. Это не распределение «первая треть A на dn1, вторая на dn2»: каждый участник цепочки получает весь блок A. Число копий не меняет логический размер исходного файла.
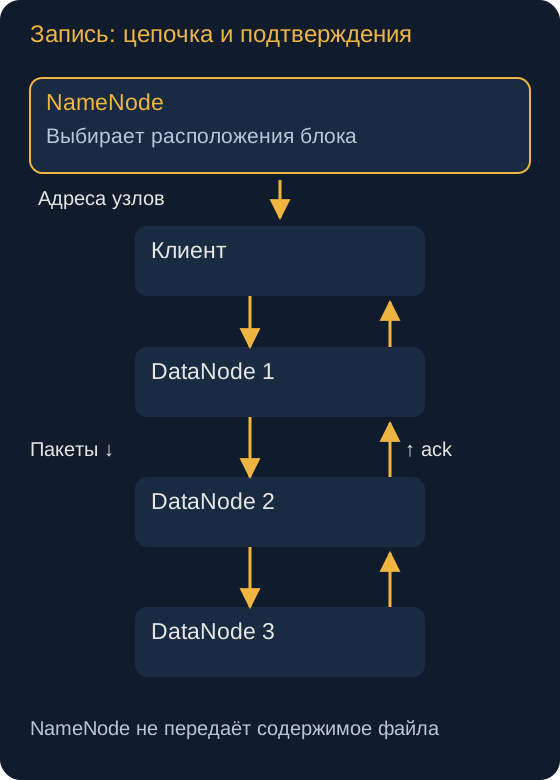
На схеме верхнее обращение относится к выбору адресов. Нижняя цепочка показывает передачу содержимого. NameNode не стоит между клиентом и первым DataNode и не пересылает каждый пакет.
3. Данные идут пакетами, подтверждения — обратно
Клиент разбивает передаваемые байты на небольшие пакеты с номерами и контрольными суммами. Контрольная сумма — число, вычисленное по порции байтов для обнаружения повреждений. Пакет — порция передачи по сети, блок — часть файла, которой управляет HDFS. Один блок передаётся многими пакетами; размер пакета не задаёт размер блока.
dn1 получает пакет, сохраняет его у себя и передаёт дальше. dn2 делает то же самое. При этом не нужно ждать получения всех 100 MB блока, чтобы начать отправку следующему участнику: несколько пакетов могут одновременно находиться в разных местах цепочки.
После обработки пакета участники отправляют подтверждения, acknowledgements, обратно: от dn3 к dn2, затем к dn1 и клиенту. Клиент учитывает подтверждённые пакеты и сохраняет неподтверждённые для возможной повторной передачи. Поэтому «отправил байты в сетевое соединение» и «получил подтверждение записи от цепочки» — разные моменты.
Подтверждение пакета не стоит трактовать как гарантию, что при одновременном обесточивании всех машин данные непременно уже окажутся на физических носителях: между программой и диском есть буферы. Принудительная синхронизация — отдельная операция API. Для обычной загрузки практическое правило проще: дождаться успешного завершения всей команды, затем проверить размер и прочитать результат.
4. Следующие блоки и закрытие файла
Когда A заполнен, клиент получает размещение B и строит цепочку для него. У B могут быть другие DataNode. Для C тоже выделяется блок, но в него записываются только оставшиеся 50 MB. HDFS не дополняет его нулями до 100 MB.
| Блок | Байты исходного файла | Полезное содержимое трёх копий |
|---|---|---|
| A | Первые 100 MB | 300 MB |
| B | Следующие 100 MB | 300 MB |
| C | Последние 50 MB | 150 MB |
Итого пользовательский файл имеет длину 250 MB, а три полные реплики его содержимого требуют около 750 MB без учёта служебных расходов. Репликация применяется к каждому блоку, хотя в интерфейсе пользователь задаёт её для файла.
После передачи клиент дожидается необходимых подтверждений и закрывает поток. NameNode завершает запись файла. Загрузка завершена после успешного закрытия потока; ошибку этого шага также нужно обработать.
Не следует объявлять поставку готовой только потому, что её имя уже появилось в каталоге. Чтение ещё открытого файла и видимость последних данных зависят от операций сброса буферов. В обычном пакетном процессе сначала завершают загрузку, проверяют результат и только после этого дают его обработчику.
Что меняется, если DataNode пропал во время записи
Предположим, dn2 перестал отвечать. Клиент обнаруживает проблему с цепочкой. Механизм восстановления исключает неисправного участника, согласует продолжение записи и повторно передаёт неподтверждённые пакеты. Восстановление происходит для затронутого блока; уже завершённые блоки всего файла не обязательно загружать заново.
Дальнейшее поведение зависит от числа живых узлов и настроек замены участников. Запись может продолжиться с меньшей избыточностью или закончиться ошибкой, если безопасно продолжить нельзя. Восстановление заданных трёх копий занимает время. NameNode организует восстановление недостающих реплик из сохранившихся.
Если оборвался сам клиент, нельзя считать незаконченный файл готовым результатом. Кластер должен завершить восстановление состояния записи, а загрузчик — проверить, что получилось, прежде чем решать, повторять ли поставку. Подробности восстановления нужны администратору; инженеру данных важно не скрыть ошибку put и не запустить расчёт на частично загруженном входе.
Чтение: сначала расположения, затем содержимое
Для get, cat или чтения из программы клиент обращается к NameNode за метаданными файла и расположениями нужных блоков. NameNode проверяет доступ и возвращает адреса доступных реплик. Он не собирает файл у себя, чтобы затем отдать клиенту.
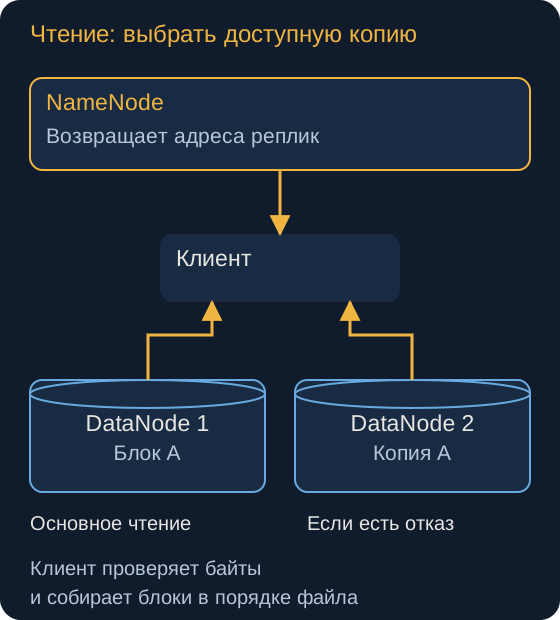
Далее чтение нашего файла выглядит так:
- Клиент выбирает реплику A, обычно близкую по сетевому расположению, и запрашивает у DataNode байты блока.
- DataNode отдаёт данные; клиент проверяет контрольные суммы и передаёт байты читающей программе.
- Дойдя до конца A, клиент переходит к B, затем к C. Они могут читаться с других DataNode.
- Программа получает исходную последовательность байтов. Команда
getпишет её в локальный файл, аcat— в стандартный вывод.
Клиенту не нужно каждый раз скачивать все три реплики и голосованием выбирать правильную. При нормальном чтении достаточно одной исправной копии каждого нужного блока. Полный get в этом примере возвращает 250 MB, а не 750 MB.
Если выбранный DataNode недоступен или проверка выявила повреждение, клиент пробует другую реплику блока. О плохой копии можно сообщить NameNode. Пока существует доступная исправная реплика, отказ одного узла не обязательно прерывает чтение. Если недоступны все копии B, наличие A и C не позволяет восстановить весь файл: репликация не умеет вычислять недостающие байты из соседних блоков.
Контрольная сумма отвечает на вопрос «изменились ли байты при хранении или передаче». Она не проверяет, что в CSV верно указана температура датчика. Неверное число может быть безупречно сохранено во всех репликах.
Чтение части файла и локальность
Приложение может запросить диапазон, например от 120 до 130 MB: эти байты находятся внутри B. Клиенту не требуется сначала прочитать A или целиком собрать файл на своём диске. Но поиск строки sensor_id = 42 HDFS не выполняет: для него нужен движок и знание формата.
Одна команда get читает поток для своего клиента. Параллельный расчёт — другая ситуация: несколько задач могут независимо читать разные диапазоны файла. Если задачу запустить на сервере с нужной репликой, меньше данных придётся передать по сети. Это локальность данных. Расположения сообщает HDFS, а место вычисления выбирает вычислительная система с учётом доступных ресурсов.
Чтобы закрепить разницу ролей, проследите два действия: переименование файла требует изменения метаданных у NameNode, а чтение большого содержимого нагружает прежде всего DataNode, диски и сеть. Увеличение числа серверов хранения помогает второй задаче, но не превращает NameNode в ненужный компонент.