Платформа данных обычно выполняет последовательность работ: получает файлы, преобразует записи и предоставляет результат для запросов. Каждый этап использует несколько компонентов. Если различать их обязанности, становится понятнее, как устроена система и что происходит при запуске расчёта.
Хранение, ресурсы и вычисления
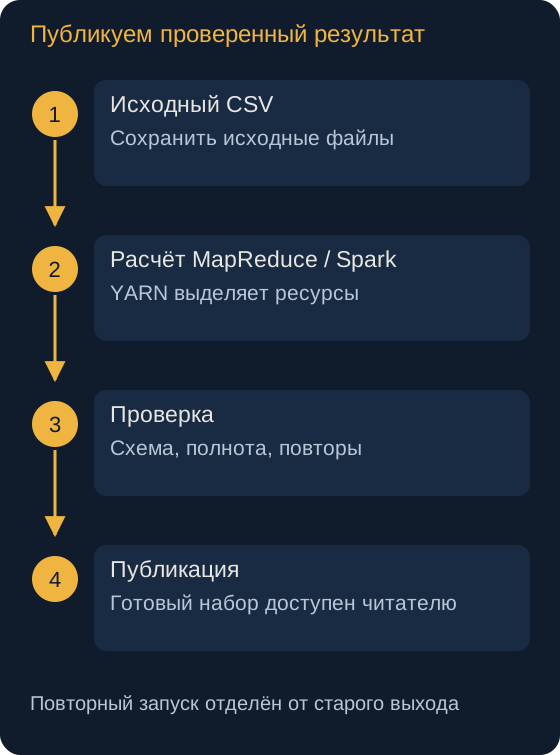
HDFS хранит файлы. Клиент создаёт путь через NameNode и передаёт содержимое DataNode. В HDFS могут одновременно лежать исходные выгрузки, очищенные наборы и итоговые таблицы. Файловая система не определяет, какие строки нужно отфильтровать или как их агрегировать.
YARN распределяет ресурсы. Приложение запрашивает память и процессоры; на выделенных узлах запускаются его процессы. ResourceManager учитывает потребности нескольких приложений. ApplicationMaster конкретного приложения организует работу в рамках полученных ресурсов.
MapReduce или Spark выполняет расчёт. Задачи читают входные части, преобразуют записи, при необходимости обмениваются промежуточными данными и записывают выход. Место чтения и число рабочих процессов связаны с планом выполнения, а не просто с числом файлов.
Сохранённый результат может состоять из нескольких файлов part-.... Каждый содержит часть записей, поэтому читатель обычно обращается ко всему каталогу набора. Выдача одного произвольно выбранного файла может потерять часть результата, даже если само приложение завершилось успешно.
Каталог и доступ через SQL
Чтобы аналитик видел таблицу, нужны её схема, формат и расположение. Эти сведения хранит Metastore. Hive получает их, строит план SQL-запроса и организует вычисление; сами строки читаются из файлов поддерживаемого хранилища.
При записи новой партиции важно согласовать файлы и каталог. Если файлы существуют, а Metastore не знает о новой партиции, запрос может её не увидеть. Если каталог уже указывает на ещё не завершённую поставку, читатель может получить неполный набор. Поэтому публикация результата включает проверку доступности и готовности данных, а не только создание имени таблицы.
HBase решает отдельную задачу — доступ к строкам по ключу. Она не является обязательным промежуточным этапом между HDFS и Hive. Набор компонентов выбирают по требуемым операциям: массовому расчёту, SQL-анализу или обращениям к отдельным записям.
Зачем нужна оркестрация
Один расчёт может зависеть от другого. Например, проверку входных файлов нужно закончить до преобразования, а обновление каталога — после успешной записи результата. Расписание «запускать всё в два часа ночи» не задаёт эти зависимости: первая задача может задержаться или завершиться ошибкой.
Оркестратор управляет порядком работ и состоянием их запусков. Он знает, какой этап ожидает вход, какой выполняется и какой завершился. Сами преобразования остаются в программах или SQL-запросах.
Apache Oozie — исторический оркестратор Hadoop-экосистемы, который можно встретить в существующих платформах. В феврале 2025 года Apache завершила развитие проекта, а в апреле перенесла его в архив Attic. Для нового учебного стенда он не требуется.
В workflow Oozie описывают действия и переходы между ними: после успешного расчёта перейти к следующему, после ошибки — к обработке сбоя. Workflow представляет собой направленный граф без циклов: зависимости определяют допустимую последовательность шагов. Описание традиционно записывается в XML.
Проверка входа → Расчёт → Проверка результата → Обновление каталога
                    ↓ ошибка
              Остановка обработки
Workflow описывает связи действий. Coordinator Oozie связывает запуск workflow с расписанием и готовностью входных наборов. Oozie передаёт вычислительные задания внешним системам и отслеживает их завершение; он не становится новым местом хранения HDFS-файлов или движком выполнения SQL.
Oozie и YARN
YARN отвечает на вопрос «где и с какими ресурсами запустить это приложение». Oozie отвечает на вопрос «когда его запускать и после каких шагов». Наличие очереди YARN не создаёт автоматически зависимость между ежедневной загрузкой и следующим отчётом. Один workflow, в свою очередь, может запустить несколько отдельных YARN-приложений.
Такая роль встречается и у других оркестраторов, например Airflow. Знание Oozie помогает читать уже построенные Hadoop-процессы; для нового проекта оркестратор выбирают отдельно от хранилища и вычислительного движка.
Запуск Spark через Airflow
В Airflow зависимости задач описывают в DAG — направленном графе без циклов. Например: проверить вход → запустить Spark → проверить результат. Для отправки программы в подготовленный кластер есть SparkSubmitOperator: он вызывает spark-submit с кодом приложения, параметрами и настройками подключения. Среде выполнения задачи Airflow нужны клиент Spark, зависимости и доступ к кластеру.
Airflow отвечает за расписание, зависимости и повтор задачи. Распределённые преобразования выполняют executors Spark, ресурсы выделяет YARN или Kubernetes. XCom — механизм передачи небольших значений между задачами Airflow. Передавать через него весь DataFrame не нужно: между шагами передают путь результата, дату обработки и идентификатор запуска. Повтор после ошибки должен учитывать, не успело ли предыдущее приложение уже записать данные.
Завершение и повтор обработки
Успех процесса означает, что он выполнил свою программу без обнаруженной ошибки. Корректность результата проверяют отдельно: читаются ли выходные файлы, совпадает ли схема, нет ли пропусков и повторов, соответствуют ли агрегаты исходным данным. HDFS не знает эти правила, а оркестратор узнает о нарушении, только если проверка оформлена как часть работы и сообщает о неуспехе.
Повтор запуска также требует правил. Если приложение успело записать часть выхода, повторная вставка может создать дубли. Используют отдельные каталоги результатов, идентификаторы поставок и согласованные правила замены. Оркестратор может повторить действие, но смысл безопасного повтора задаёт программа.