Большой файл удобно хранить частями: их можно распределить по дискам, читать параллельно и восстанавливать независимо. HDFS делит содержимое на блоки. У каждого блока есть идентификатор, длина и расположения копий.
Блок — не строка таблицы
Возьмём условный файл 300 MB и для простоты расчёта зададим блок 100 MB. Получатся три блока: A, B и C. Если задать три копии, на дисках будут три A, три B и три C. Пользователь по-прежнему читает один файл размером 300 MB. Копирование увеличило расход хранения, а не число строк логического файла.
В Hadoop 3.4.3 размер блока по умолчанию — 134217728 байт: точно 128 MiB, примерно 134 MB. MB — мегабайт, 1 000 000 байт; MiB — мебибайт, 1 048 576 байт. В обычных примерах используем MB, а здесь различие важно для точного значения настройки. Размер можно задавать при создании файла; встречается и другая конфигурация кластера.
Последний неполный блок не заполняется пустотой до максимума. Файл из 39 байт не требует целого блока полезных данных на 134 MB. Но его имя, блок и копии всё равно требуют служебного учёта.
Файл 200 MB при блоке 128 MB
Теперь зададим размер блока ровно 128 MB и запишем файл 200 MB. Здесь MB — десятичные мегабайты по условию примера; это отдельная настройка, а не точное значение по умолчанию, приведённое выше.
| Что считаем | Результат |
|---|---|
| Логические блоки файла | Два: 128 MB и 72 MB |
| Копии при коэффициенте репликации 3 | Три копии каждого блока, всего шесть реплик блоков |
| Объём содержимого на дисках | 3 × 128 + 3 × 72 = 600 MB |
| Размер файла для читателя | 200 MB |
Число 768 MB получилось бы из ошибочного предположения, что все шесть копий занимают по 128 MB полезных данных. Последний блок содержит только оставшиеся 72 MB. Реальный расход дисков будет немного больше 600 MB из-за контрольных сумм и других служебных данных. Шесть реплик блоков также не означают шесть серверов: один DataNode может хранить копии разных блоков.
Почему блоки крупные
Открыть соединение, найти нужное место на диске и запросить расположение у NameNode тоже стоит времени. Когда после этих действий программа долго читает большой непрерывный участок, служебные затраты распределяются на много полезных байтов. Если сделать блоки совсем маленькими, возрастут число записей в метаданных и частота переключений между ними.
Но делать весь многотерабайтный файл единственным блоком тоже неудобно: его копия должна помещаться на одном узле, а распределить обработку и восстановление будет сложнее. Блок — единица размещения и репликации. Это не размер строки CSV и не обещание, что клиент при каждом запросе обязан скачать блок целиком: читать можно нужный диапазон байтов.
Зачем несколько копий
Реплика — копия тех же байтов блока на другом DataNode — сервере хранения. Коэффициент репликации 3 означает желаемые три копии одного блока на трёх разных серверах. Если один DataNode перестал отвечать, клиент может прочитать доступную реплику на другом. NameNode обнаруживает недостающую избыточность и организует создание новых копий на подходящих узлах.
При трёх копиях файл 300 MB требует около 900 MB под содержимое, плюс служебные расходы. Свободное место нельзя планировать только по размеру исходных файлов. После отказа восстановление копий занимает время; фактическую репликацию проверяют отдельно.
В дата-центре серверы стоят в стойках и могут зависеть от общего питания и сетевого оборудования. HDFS умеет учитывать стойки при размещении копий. Например, для трёх реплик типична раскладка между двумя стойками. Это уменьшает вероятность одновременной потери всех копий при локальном отказе.
Разные стойки не обязательно находятся в разных городах. Защита от потери целого дата-центра — отдельная задача. А три контейнера на одном ноутбуке используют одну физическую машину, даже если называются разными DataNode.
Репликация не заменяет резервную копию. Если удалить логический файл или записать неправильные данные, наличие нескольких реплик не вернёт прежний смысл содержимого.
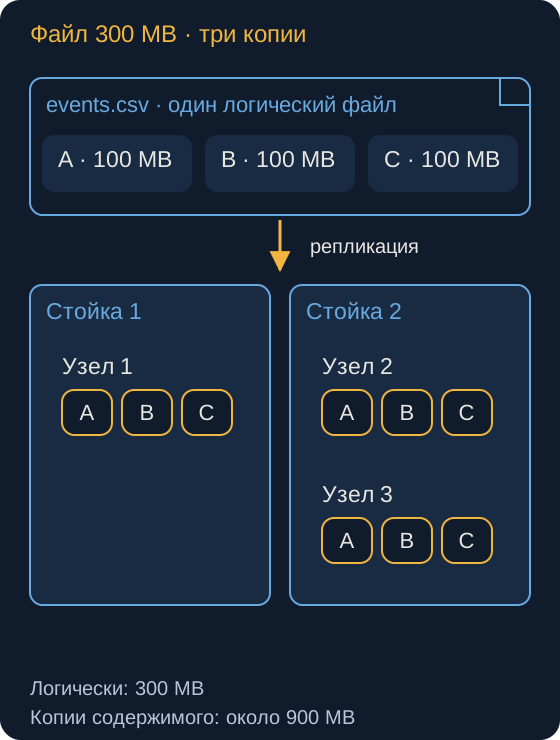
На схеме один файл 300 MB разделён на A, B и C. У каждого блока три копии, распределённые между двумя стойками. Репликацию задают для файла: соседний файл может иметь другое желаемое число копий.
Почему неудобен миллион маленьких файлов
У двух наборов может быть одинаковый общий размер: один лежит в десятке крупных файлов, другой — в миллионе маленьких. Во втором случае NameNode должен учитывать гораздо больше имён и блоков. Вычислитель также чаще открывает файлы и создаёт мелкие единицы работы. Служебные действия могут стоить больше, чем чтение полезных байтов.
Например, 100 000 файлов по 10 KB дают около 1 GB содержимого, но требуют 100 000 имён и как минимум столько же блоков. Один файл на тот же объём при стандартном размере блока требует лишь несколько блоков. Разница в служебном учёте огромна, хотя суммарный объём полезных данных одинаков. Это не значит, что все данные озера нужно склеить в один файл: каталоги дат и возможность параллельного чтения тоже полезны.
Чтобы уменьшить число файлов, загрузки собирают более крупными порциями, а накопившиеся мелкие результаты периодически переписывают в несколько крупных файлов. Такой процесс называют compaction, укрупнением файлов. Вычислительный движок читает исходные записи и записывает новый набор; после проверки и переключения читателей ненужные мелкие файлы можно удалить.
У форматов вроде Parquet нельзя просто соединить байты файлов командой cat: у каждого файла собственная структура и метаданные. Укрупнение должно сохранять корректный формат. Также стоит ограничивать число выходных файлов расчёта и не делить небольшой набор на тысячи каталогов по почти уникальному ключу.
Увеличение памяти NameNode может временно дать запас, но не уменьшает количество имён и обращений. Уменьшение размера блока тоже не объединяет файлы: у каждого маленького файла остаётся собственный блок. Конкретный размер итоговых файлов выбирают под движок, объём и частоту загрузки; универсального правила «всегда ровно один блок» нет.
CSV хранит текстовые записи; Parquet — данные по колонкам с дополнительной структурой и статистикой. Parquet может уменьшить объём чтения запроса, но решение пропустить колонки или части набора принимает движок, понимающий формат. HDFS не знает, что запросу нужны только записи с двумя определёнными значениями ключа.