Для пользователя файл /logs/day-01/events.csv выглядит как один файл. Но его части могут находиться на разных серверах. HDFS — Hadoop Distributed File System — даёт этому распределённому хранению общее дерево каталогов и единые операции: создать файл, прочитать, переименовать, удалить.
Её можно сравнить с библиотекой, где есть каталог и полки в нескольких помещениях. Каталог говорит, где искать том, но не хранит все страницы книг внутри карточек. Аналогия помогает разделить сведения о файле и его содержимое.
NameNode, DataNode и клиент
NameNode ведёт пространство имён: каталоги, имена файлов, права, размеры и список частей каждого файла. Эти сведения называют метаданными — данными об устройстве хранения. Для быстрых ответов NameNode держит рабочее представление метаданных в памяти.
DataNode хранит части файлов на локальных дисках и отдаёт их клиентам. Часть файла в HDFS называют блоком. DataNode периодически сообщает NameNode, что работает, и передаёт список своих блоков.
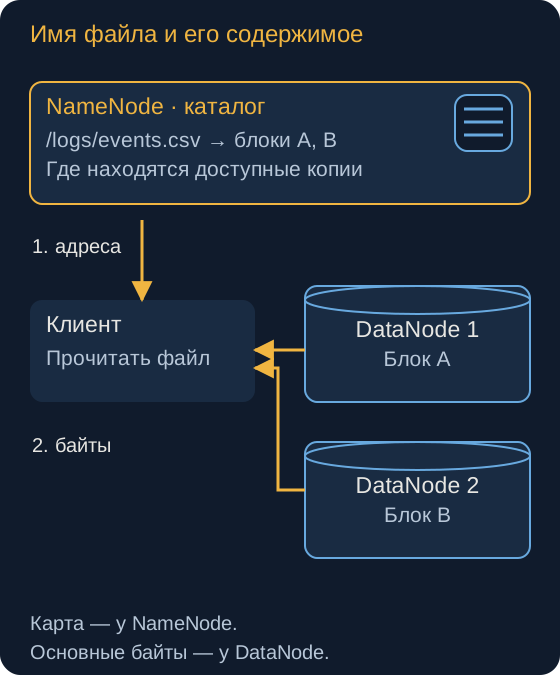
На схеме отделены два потока: запрос расположения файла к NameNode и передача его байтов между клиентом и DataNode. Один сервер может хранить блоки разных файлов.
Клиент — программа, обращающаяся к HDFS. Это может быть команда hdfs dfs, Spark или другое приложение. Сначала клиент узнаёт у NameNode расположение блоков, затем обменивается содержимым напрямую с DataNode. Через NameNode не проходит весь многогигабайтный файл.
В схемах платформ встречается ClientNode или edge node: машина с клиентскими программами и настройками доступа. Это удобная точка входа пользователя, а не третий обязательный сервер хранения наряду с NameNode и DataNode. Клиентская программа может запускаться и на других узлах.
Как имя связано с содержимым
Для /logs/day-01/events.csv можно представить два разных справочника. Первый связывает путь со списком блоков: events.csv → A, B, C. Второй связывает каждый блок с узлами, где есть его копии: A → dn1, dn3, dn4. Это условные обозначения: в HDFS блокам назначаются собственные идентификаторы.
DataNode хранит локальный файл блока, но не обязан иметь у себя каталог /logs/day-01 или целый events.csv. Поэтому нельзя зайти на случайный DataNode и искать пользовательский CSV по его HDFS-пути. Полную последовательность клиент получает через службу метаданных. При переименовании файла в той же HDFS меняется запись в пространстве имён; пересылать все блоки по сети ради нового имени не требуется.
Узлы посылают heartbeat, короткое сообщение о том, что процесс работает. Отдельные block reports, отчёты о блоках, сообщают, какие блоки реально находятся на узле. Это разные сведения: работающий сервер может не содержать нужной копии. Если сообщения перестали приходить, NameNode после установленного ожидания считает узел недоступным и перестаёт предлагать его клиентам.
Допустим, файл занимает три блока, у каждого по три копии. После потери одного DataNode файл можно прочитать по оставшимся копиям всех его блоков. NameNode видит, каких копий стало меньше заданного числа, и организует восстановление реплик на других узлах. Если все копии хотя бы одного блока недоступны, путь к файлу может остаться в каталоге, но прочитать файл целиком не получится.
Копии полезно размещать с учётом стоек: несколько узлов в одной стойке могут зависеть от общего сетевого оборудования или питания. Политика размещения учитывает топологию, чтобы отказ одной стойки не сделал все копии блока недоступными. Конкретное размещение зависит от размера и настроек кластера; схема с тремя копиями не обещает, что каждая окажется в отдельной стойке.
Такое разделение помогает масштабировать передачу: много клиентов читают с разных DataNode одновременно. Но служба метаданных всё равно имеет пределы по памяти и количеству запросов. Поэтому большое число крошечных файлов создаёт нагрузку даже тогда, когда диски ещё почти пусты.
Что останется после перезапуска NameNode
Держать карту только в оперативной памяти было бы недостаточно. FsImage сохраняет снимок пространства имён на диске. Более поздние изменения — например создание каталога и переименование файла — записываются в журнал edits. При восстановлении система использует снимок и изменения после него.
Со временем журнал растёт. Checkpoint объединяет снимок с накопленными изменениями и создаёт новый снимок. Это похоже на сохранение новой версии документа после серии правок, чтобы не воспроизводить всю историю с самого начала.
Расположения живых реплик уточняются по отчётам DataNode: одного FsImage недостаточно, чтобы узнать, какие копии сейчас доступны.
Secondary NameNode и резервный NameNode
Secondary NameNode периодически получает FsImage и edits, объединяет их и возвращает новый снимок. Это позволяет ограничивать рост журнала и сокращать объём его воспроизведения при запуске NameNode. Пользовательские блоки в этой операции не копируются: они по-прежнему находятся на DataNode.
Слово Secondary легко принять за «запасной», но этот процесс не обслуживает клиентов вместо отказавшего NameNode автоматически. Последняя контрольная точка также может не содержать последних изменений. Для высокой доступности используют отдельно настроенную пару Active/Standby NameNode: активный обслуживает запросы, резервный поддерживает актуальное состояние для переключения. В такой схеме контрольные точки выполняет Standby; отдельный Secondary NameNode не нужен.
Высокая доступность NameNode и несколько копий блоков решают разные проблемы. Можно иметь три копии каждого блока, но не читать их, пока недоступна служба метаданных. И наоборот: резервный NameNode не создаст утраченную копию пользовательского блока. В рабочем кластере проверяют обе стороны — доступность пространства имён и достаточное число здоровых реплик данных.
Что HDFS обещает приложению
HDFS рассчитана прежде всего на большие файлы и последовательное чтение больших объёмов. Типичный сценарий: записать поставку, закрыть файл, затем много раз читать её для расчётов. Это отличается от базы, в которой постоянно обновляют отдельную строку по ключу. Произвольно заменить байты в середине HDFS-файла нельзя как обычную SQL-запись; для исправлений часто формируют новую версию набора.
HDFS не разбирает смысл amount_rub и не выполняет WHERE. Она хранит байты. CSV, Parquet и SQL-таблица — другие уровни: формат определяет устройство записей, а вычислительный движок понимает колонки и условия запроса.
Поэтому при ошибке важно различать два случая. Если клиент не может найти имя файла, проверяют путь и метаданные. Если имя известно, но некоторые блоки недоступны, проверяют их расположения и DataNode.