При загрузке файла важно понимать, кто читает байты и как они попадают на сегменты. COPY через клиентское соединение и чтение через gpfdist решают похожую задачу разными путями. От выбранного пути зависят узкое место, настройка доступа и способ повторного запуска.
COPY через клиент
COPY FROM STDIN получает поток через соединение с coordinator. Например, psql может открыть локальный файл и передать его содержимое команде COPY. Coordinator принимает поток, а строки распределяются в целевую таблицу по её политике.
Для инженера это удобный путь: не нужно делать файловый сервер доступным всем сегментам. Но вход ограничен клиентом, его соединением и обработкой на coordinator. Если исходный поток медленный, свободные сегменты не заставят его поступать быстрее.
Нужно различать клиентскую \copy и серверную COPY с именем файла. Первая читает файл там, где запущен клиент psql; вторая обращается к файловой системе серверного процесса и требует соответствующего доступа. Путь на ноутбуке не становится путём на сервере только потому, что SQL отправлен в Greenplum.
gpfdist: сегменты читают параллельно
gpfdist — утилита раздачи файлов для параллельной загрузки и выгрузки Greenplum. Её запускают на узле, где доступны нужные файлы. Вместо передачи всего содержимого через клиентское подключение сегменты читают поток с этого узла напрямую.
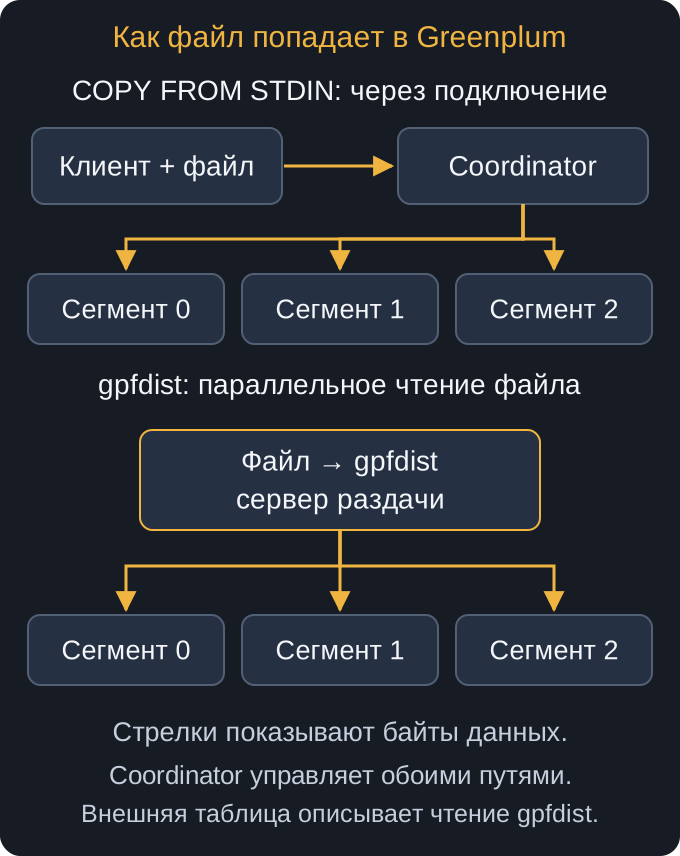
Вторая дорожка на рисунке показывает путь данных. SQL по-прежнему отправляется coordinator, который организует запрос. Но байты файла идут от gpfdist к исполнителям. Несколько файлов и серверов раздачи могут повысить параллелизм, если источник, сеть и принимающие диски способны его обслужить.
Параллельность не означает, что каждый сегмент загружает полную копию одного файла. Greenplum и gpfdist согласуют выдачу данных читателям. После чтения строки могут дополнительно перемещаться к нужным целевым сегментам согласно распределению внутренней таблицы.
Что создаёт внешняя таблица
Readable external table хранит описание: колонки, формат, расположение данных и параметры чтения. Адрес вида gpfdist://load-files.example:8081/records.csv указывает на сервер раздачи и файл. Это пример адреса, а не готовая конфигурация стенда.
Создание внешней таблицы не выполняет загрузку файла во внутреннее хранение. При SELECT база читает внешний источник. Для материализации используют запись из внешнего набора во внутреннюю таблицу, например через INSERT SELECT. Именно у внутренней таблицы выбирают AO или heap, сжатие, распределение и партиции.
Обращение к внешнему файлу и локальное хранение имеют разный жизненный цикл. Если файл переименовали или сервер раздачи недоступен, внешнее чтение завершится ошибкой. Уже загруженные внутренние данные от доступности этого файла не зависят. Обратный путь также существует: writable external table позволяет выгружать поток в настроенный приёмник.
Зачем нужен staging
Staging — промежуточный слой загрузки. Он отделяет техническое чтение файла от публикации данных в основной таблице. Здесь проверяют формат, типы, допустимые значения и полноту, а затем выполняют нужное преобразование и запись в целевой слой.
В одном процессе может быть сначала техническая таблица с более мягкими типами, затем проверенный набор с целевой структурой. Это помогает сохранить причину отказа строки и не путать ошибку разбора CSV с нарушением бизнес-правила. Но лишние копии имеют стоимость, поэтому число промежуточных этапов должно быть обосновано проверками.
Для повторяемой загрузки фиксируют состав входа и идентификатор запуска. Повторное чтение того же файла не должно незаметно удваивать данные. Способ повтора зависит от слоя: очистить собственный промежуточный набор, заменить согласованный период или применить проверенную дедупликацию. Сам gpfdist не определяет эту логику.
Ошибки и полнота
У внешних таблиц есть режимы обработки допустимых ошибок строк, включая журналирование и reject limit. Лимит применяется по сегментам, поэтому его нельзя читать как одну общую квоту на весь файл. Не всякая ошибка может быть пропущена: недоступный источник или ошибка исполнения не становятся обычной отвергнутой строкой CSV.
Разрешённый пропуск требует сверки. Проверяют количество прочитанных, принятых и отвергнутых записей, состав файлов и контрольные показатели по важным полям. Успешное завершение команды ещё не доказывает, что опубликован полный набор. Причину каждого допустимого отклонения нужно уметь объяснить.
Для CSV заранее согласуют разделитель, кавычки, NULL, кодировку, заголовок и представление дат. Один файл с заголовком и другой без него — разные входные контракты. Несколько загрузочных потоков также должны видеть законченные файлы, а не частично дописываемые выгрузки.
После существенной загрузки обновляют статистику ANALYZE и проверяют размещение данных. Выбранный способ доставки не исправляет плохой ключ распределения. Если строки с одним частым ключом собрались вместе, следующая агрегация или JOIN всё равно может упереться в один сегмент.
Чем отличается PXF
gpfdist раздаёт подготовленные файлы. PXF предоставляет другой слой доступа: через коннекторы к объектному хранилищу, HDFS или внешней SQL-базе. У него свои сервисы, профили и возможности переноса обработки к источнику. Этот путь разобран отдельно в уроке PXF, чтобы не смешивать файловую раздачу с доступом к внешней системе.