Часть данных может оставаться за пределами Greenplum: в S3-совместимом хранилище, HDFS или другой SQL-базе. PXF даёт сегментам путь к таким источникам через внешние таблицы. Прежде чем решать, читать ли данные на месте или переносить внутрь, нужно понять участников этого пути.
Где работает PXF
PXF, Platform Extension Framework, состоит из расширения в Greenplum и сервисов доступа к источникам. Экземпляр сервиса обычно работает на каждом segment host. Несколько сегментов одного хоста обращаются к его сервису; отдельный сервис на каждый процесс сегмента не требуется.
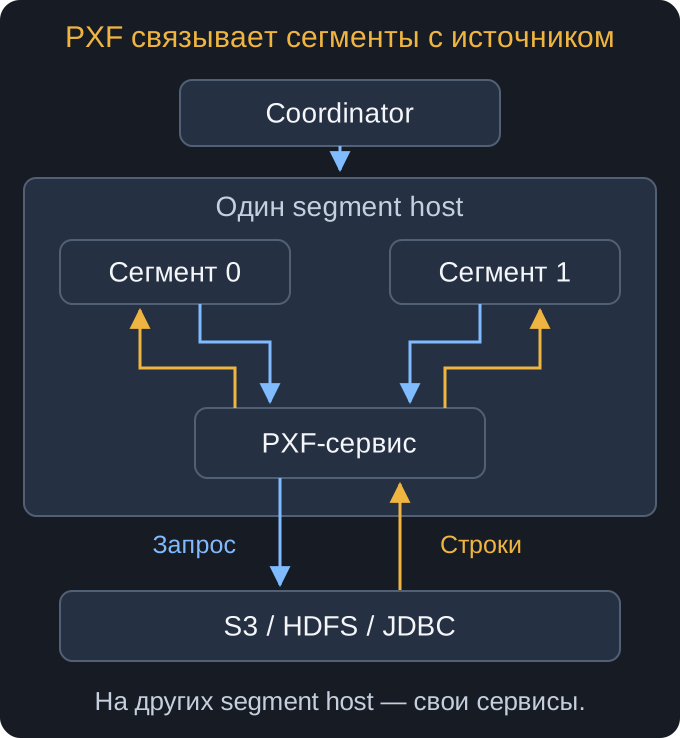
Клиент отправляет обычный SQL coordinator. План назначает чтение исполнителям, те обращаются к PXF на своих хостах. PXF использует коннектор к источнику, получает данные и возвращает строки сегментам для дальнейшей обработки. Сам coordinator не становится единственным файловым читателем всего внешнего набора.
На схеме один segment host показан крупно; в кластере таких хостов может быть несколько. Для параллельного чтения всем участвующим сервисам нужны доступ к источнику и согласованная конфигурация. Работающий сервис на одном хосте ещё не доказывает исправность пути на остальных.
Что описывает внешняя таблица
Внешняя таблица задаёт колонки и путь доступа. Профиль выбирает способ чтения и интерпретации данных: например, текст в объектном хранилище или JDBC. SERVER ссылается на именованную конфигурацию подключения PXF. Само имя сервера в SQL не является паролем и не заменяет настройку доступа.
Параметры адреса, профиль и формат должны соответствовать источнику. Текстовый CSV, Parquet и JDBC требуют разных правил чтения. Параметр из примера для одной версии PXF не обязательно допустим в другой; PXF имеет собственную версию и матрицу совместимости с Greenplum.
Для CSV заранее согласуют заголовок, разделитель, NULL, кодировку и преобразование типов. Отсутствие подходящего правила заголовка нельзя исправлять произвольным добавлением HEADER в незнакомый синтаксис внешней таблицы. Сначала проверяют возможности конкретного профиля и формата.
Как и у других внешних таблиц, создание DDL добавляет метаданные. Данные остаются в источнике. Чтение может снова обращаться к тем же объектам при каждом запросе, а изменение файлов способно изменить результат следующего чтения без INSERT в Greenplum.
Фрагменты и параллелизм
Чтобы несколько исполнителей читали одновременно, внешний набор делят на фрагменты. Ими могут быть файлы, части подходящего файлового формата или диапазоны JDBC-чтения. Способ деления зависит от коннектора и возможностей источника.
Один большой несекционируемый сжатый файл способен ограничить параллелизм, даже если сегментов много. С другой стороны, множество очень мелких файлов создаёт расходы на перечисление объектов и открытие соединений. Число файлов, их размер и делимость формата нужно рассматривать вместе.
В случае JDBC параллельные обращения увеличивают нагрузку на внешнюю базу. Разделение по диапазонам должно покрывать нужные данные без пропусков и пересечений. Если источник меняется во время нескольких чтений, отдельно проверяют согласованность полученного набора: внешняя таблица сама по себе не даёт общий транзакционный снимок разных систем.
Pushdown: сделать часть работы у источника
Pushdown переносит поддерживаемую обработку ближе к данным. Если JDBC-коннектор передаст источнику фильтр, в Greenplum придёт меньше строк. Если профиль умеет читать только нужные колонки подходящего формата, уменьшится объём чтения. Выигрыш связан с тем, какая работа действительно была выполнена раньше.
Поддержка зависит от профиля, формата, типа условия и версии. Нельзя обещать pushdown любого WHERE, JOIN или агрегата. Наличие фильтра в SQL ещё не означает, что его выполнил источник. Проверяют план, доступную диагностику PXF и фактический объём чтения.
Оставшаяся часть запроса выполняется Greenplum. Например, после внешнего чтения строки могут потребовать Redistribute перед JOIN с внутренней таблицей. Внешний доступ и распределение потока внутри кластера — разные этапы, каждый со своей стоимостью.
Читать снаружи или загрузить внутрь
Прямое чтение удобно для разового исследования или обращения к данным, которые не хочется дублировать. За это платят зависимостью от источника, сети и его нагрузки при каждом обращении. Внутреннее хранение даёт управляемое распределение, статистику и привычный цикл обслуживания ценой копии и отдельной загрузки.
Если набор многократно участвует в тяжёлых соединениях, материализация может окупиться. Сначала данные читают через PXF, проверяют, затем записывают во внутреннюю таблицу с подходящими ключом и хранением. После загрузки собирают статистику. Частота обновления этой копии становится частью контракта свежести.
Где искать причину ошибки
Путь состоит из нескольких границ: сегмент → сервис PXF → сеть и авторизация источника → разбор данных. Ошибка типа колонки отличается от недоступности сервиса или запрещённого объекта. Полезно установить, какие хосты затронуты и на каком этапе чтение остановилось.
Проверка результата включает не только успешный SELECT, но и состав входа, число строк, границы периода и допустимые отклонения. gpfdist из урока загрузки решает более узкую задачу раздачи файлов. PXF добавляет коннекторы и связанные с ними возможности, но требует понимать внешний источник как часть всего запроса.