Две таблицы с одинаковыми колонками могут по-разному читать, записывать и сжимать данные. В Greenplum способ физического хранения выбирают по характеру работы: часто ли меняются отдельные записи, сколько колонок читают запросы, как поступают новые данные. Затем отдельно определяют распределение, партиции и срок жизни таблицы.
Четыре независимых вопроса
Сначала полезно разделить признаки, которые часто называют одним словом «тип». Метод доступа определяет организацию внутреннего хранения: heap, AO row или AO column. Политика распределения определяет размещение строк по сегментам. Партиционирование выделяет логические части. Временная или постоянная таблица различается сроком жизни, а внешняя — местом нахождения данных и способом доступа.
Поэтому таблица может одновременно быть постоянной, колоночной AO, распределённой по ключу и разделённой на месячные партиции. Эти признаки отвечают на разные вопросы. Однако не все сочетания допустимы: например, replicated-таблицу нельзя сделать партиционированной. Сначала выбирают смысл каждого решения, затем проверяют ограничения их сочетания.
Heap: значения строки рядом
Heap хранит записи на страницах. Значения одной строки расположены вместе, поэтому организация удобна для работы с отдельными записями и чтения их полей. При изменениях действует многоверсионность: старое состояние может ещё понадобиться транзакции, которая начала чтение раньше.
Обновление не означает немедленную замену всех байтов на диске. Появляется новая версия, а устаревшую можно убрать, когда она больше никому не нужна. Это создаёт работу для VACUUM и влияет на размер таблицы и индексов. Heap не избавляет от обслуживания, даже если число логических строк почти не меняется.
Часто изменяемое состояние — разумный кандидат для heap. Но строковый формат не отменяет распределённую природу Greenplum: одиночная операция всё равно имеет расходы на координацию и транзакцию. Выбор heap внутри аналитической базы не превращает всю систему в оптимальный OLTP-сервер.
Append-optimized: крупные добавления
Append-optimized, AO, организует хранение для массового добавления и чтения данных. В отличие от heap с обычными страницами и версиями строк, у AO собственная организация файлов и служебных структур видимости. Есть две ориентации: строковая AO row и колоночная AO column, которую также называют AOCO.
В AO row значения записи хранятся вместе. Это подходит для загружаемых пакетами наборов, когда запросам нужна заметная часть полей. Формат поддерживает сжатие, поэтому выбор между heap и AO row касается не только ориентации, но и характера записи, чтения и обслуживания.
Название не означает запрета UPDATE и DELETE. Эти операции поддерживаются, но старые данные помечаются скрытыми, а обновлённые записываются заново. Позже compaction переносит видимые строки и освобождает старые файлы. Частая мелкая перезапись может свести на нет ожидаемое преимущество AO. Механизм очистки подробно разобран в уроке VACUUM.
AO column: читать нужные колонки
В AO column значения каждой колонки хранятся отдельно. Если у таблицы десятки полей, а расчёту нужны только дата и числовое значение, чтение ненужных текстовых полей можно избежать. Этот выигрыш зависит от проекции — набора колонок, которые действительно нужны запросу.
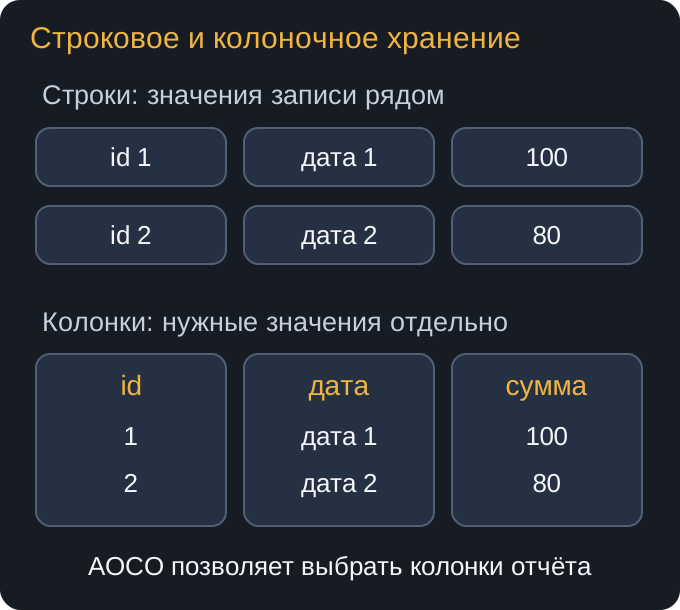
На схеме одинаковые логические строки разложены двумя способами. Для суммы по числовой колонке колоночный формат читает её данные отдельно. Для восстановления всех полей отдельной записи придётся собрать значения из разных колонок. Поэтому «колоночный» не означает «быстрее для любого SELECT».
АОCO особенно полезен для широкой истории, которую загружают большими порциями и читают по нескольким полям. При этом фильтр должен быть применим к имеющимся данным, а сам запрос — оставлять небольшую проекцию. SELECT * по всей таблице не получает экономию от пропуска колонок.
Колоночная ориентация также не устраняет стоимость изменений AO. После обновления появляются скрытые старые значения и новые данные, которым требуется обслуживание. Если набор постоянно исправляется построчно, нужно оценить весь цикл, включая загрузку и compaction, а не только время одного аналитического чтения.
Сжатие: меньше чтения, больше вычислений
Сжатие уменьшает объём хранимых данных и передаваемых с диска байтов. На него тратится CPU при записи и распаковке. Значения одной колонки часто похожи по типу и структуре, поэтому колоночное хранение может хорошо сжиматься. Однако итог зависит от данных: случайные значения и повторяющиеся категории дают разный результат.
В Greenplum 7 AO row и AO column поддерживают, в частности, zlib и zstd; RLE_TYPE относится к колоночному AO. RLE кодирует повторяющиеся последовательности, поэтому его эффект связан с характером и порядком значений. Алгоритм и уровень выбирают измерением размера, скорости загрузки, чтения и расхода CPU.
Один короткий DDL показывает два отдельных решения — метод хранения и размещение:
CREATE TABLE measurements (
    record_id bigint,
    event_date date,
    value numeric
) USING ao_column
WITH (compresstype = zstd, compresslevel = 3)
DISTRIBUTED BY (record_id);
USING ao_column выбирает хранение, WITH — сжатие, DISTRIBUTED BY — сегмент для строки. Здесь нет партиционирования или объявления уникальности. В материалах Greenplum 6 те же идеи часто записаны через appendonly и orientation; при работе со стендом сначала проверяют его версию.
Сравнение под нагрузку
| Свойство | Heap | AO row | AO column |
|---|---|---|---|
| Организация | Версии строк на страницах | Строки в AO-хранении | Значения колонок отдельно |
| Основной профиль | Частые изменения записей | Пакетная запись, чтение многих полей | Пакетная запись, чтение части полей |
| Сжатие AO | Не применяется | Поддерживается | Поддерживается, включая RLE_TYPE |
| UPDATE и DELETE | Создают работу с версиями | Оставляют скрытые данные | Оставляют скрытые данные |
| Обслуживание | VACUUM и индексы | VACUUM, compaction | VACUUM, compaction |
Это отправная точка выбора, а не рейтинг скорости. Для сравнения берут характерные запросы и полный цикл изменения данных. Измеряют объём, время загрузки и чтения, перекос сегментов, стоимость обслуживания. Вариант, выигравший один SELECT, может проиграть при ежедневной перезагрузке.
Временные и внешние таблицы
Временная таблица живёт в сессии и подходит для повторно используемого промежуточного результата. Она имеет обычное физическое хранение, распределение и может занимать диск. Это материализация: сначала нужно записать набор, затем читать его в следующих шагах. Для маленького однократного выражения отдельная запись может оказаться лишней.
ON COMMIT определяет поведение при завершении транзакции: сохранить строки, удалить их или удалить таблицу. В режиме autocommit транзакция заканчивается после команды, поэтому ON COMMIT DROP требует особенно внимательного использования. После наполнения временной таблицы для дальнейших соединений может понадобиться ANALYZE: оптимизатору нужны оценки её размера и значений.
Внешняя таблица описывает данные за пределами внутреннего хранения. DDL создаёт метаданные доступа, а не копирует содержимое файлов. Readable-таблица служит для чтения, writable — для вывода данных; её нельзя считать обычной внутренней таблицей с произвольными UPDATE и DELETE.
Внешние таблицы могут использовать gpfdist или PXF. При переносе во внутреннюю таблицу появляются её собственные распределение, хранение и статистика. Путь файла разобран в уроке загрузки, доступ к внешним системам — в уроке PXF.
Индексы и ограничения
Индексы в Greenplum существуют. Их полезность зависит от селективности, метода доступа и стоимости обслуживания; массовое сканирование не обязано выигрывать от индекса. Утверждение «в аналитической базе индексов нет» неверно.
Уникальность тоже связана с распределением. Для hash-таблицы уникальный ключ должен включать колонки распределения: иначе одинаковые значения могут оказаться на разных сегментах, где локальная проверка их не сопоставит. Для партиционированной таблицы добавляются требования к ключу партиционирования. В Greenplum 7 уникальные индексы поддерживаются и на AO; старое правило «AO не поддерживает UNIQUE» нельзя переносить из документации версии 6.
Объявленный FOREIGN KEY не обеспечивает автоматическую проверку ссылочной целостности в Greenplum. Корректность связей проверяют в загрузке и контролях качества. Таким образом, выбор таблицы заканчивается не DDL: нужно понимать, какие гарантии действительно обеспечивает движок и что остаётся обязанностью обработки данных.