Клиент видит Greenplum как одну базу. Внутри запрос проходит через coordinator, а большую часть чтения и вычислений выполняют сегменты. Чтобы понимать план и последствия отказа, нужно различать три вещи: физический сервер, работающий экземпляр базы и резервную копию этого экземпляра.
Coordinator и primary segments
Coordinator — точка подключения клиента. Он проверяет доступ, использует глобальный системный каталог, разбирает SQL и организует выполнение плана. Каталог описывает таблицы, роли и устройство кластера. Пользовательские данные внутренних таблиц находятся на сегментах. В старых материалах coordinator называют master.
Primary segment — активный экземпляр базы, который хранит свою часть данных и выполняет порученные ему операции. Например, он читает строки, строит хеш-таблицу для соединения или считает локальный агрегат. Для распределённой таблицы разные primary совместно хранят её полный набор строк.
Segment host — сервер, на котором запущены экземпляры сегментов. На одном хосте их может быть несколько. Поэтому четыре сегмента не обязательно означают четыре машины: экземпляры одного хоста используют его общие CPU, память и диски. Запуск дополнительных экземпляров не создаёт новых физических ресурсов.
Как выполняется один запрос
Возьмём сумму числовой колонки по всей таблице. После получения SQL coordinator выбирает план и отправляет его части исполнителям. Каждый primary читает свою часть, считает частичную сумму и передаёт её для окончательного объединения. В этой схеме передаются три числа вместо всех исходных строк.
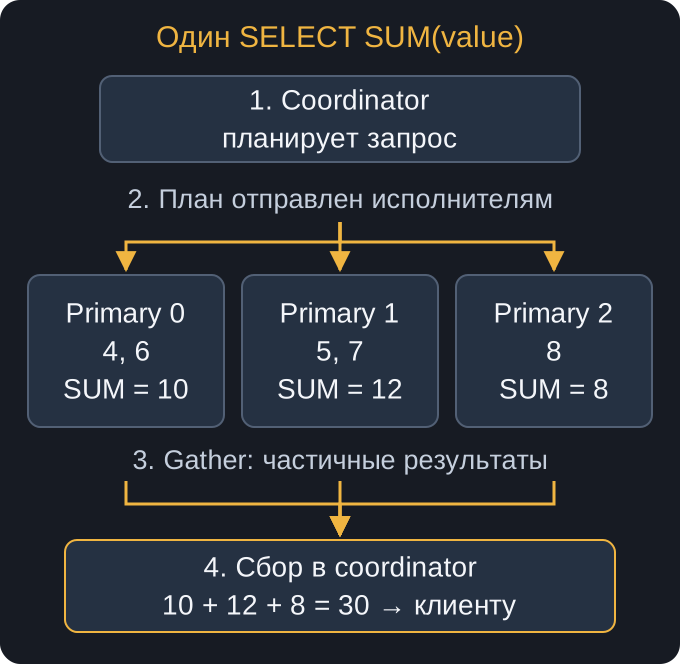
На рисунке показан простой план с локальной и окончательной агрегацией. У реального запроса могут быть дополнительные стадии: соединение, сортировка, перераспределение строк. Не каждый оператор обязательно выполняется на всех сегментах, а место окончательной агрегации зависит от плана. Главное — SQL один, но его физические операции распределены.
Interconnect — сетевой слой обмена между исполнителями Greenplum. По нему передаются промежуточные строки и результаты; в плане такой обмен представлен операторами Motion. Иногда достаточно собрать небольшие частичные итоги, иногда приходится переслать большой набор для JOIN. Поэтому важны и пропускная способность сети, и количество передаваемых данных. Конкретные виды Motion разберём в уроке о соединениях.
Зачем primary нужна mirror
Mirror segment хранит резервную копию данных конкретного primary. Это копия того же участка таблиц, поэтому зеркало не увеличивает логический объём данных и не добавляет ещё один независимый шард. При исправном primary рабочий запрос выполняется на активной копии, а зеркало получает изменения.
Зеркало размещают на другом физическом хосте. Если обе копии находятся на одной машине, её отказ уничтожит доступ сразу к обеим. На схеме два хоста: primary 0 соседствует с зеркалом части 1, а primary 1 — с зеркалом части 0. Стрелки связывают одинаковые номера частей через границу хостов.
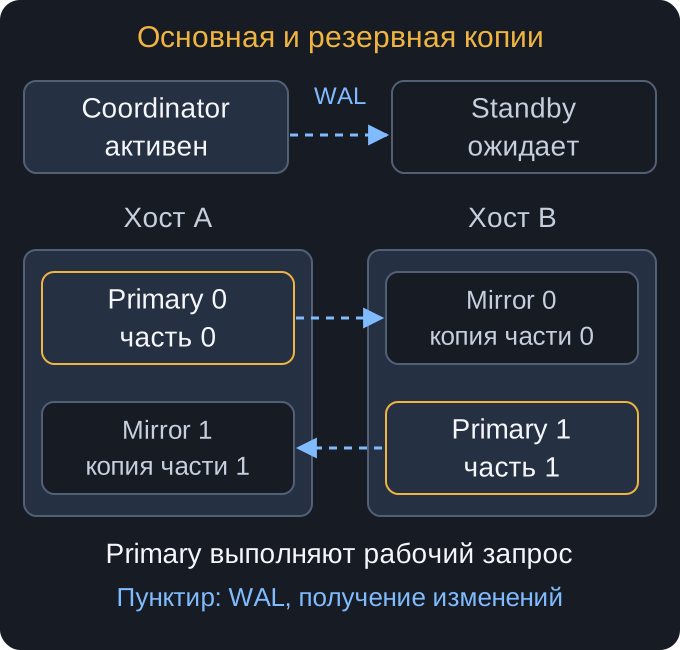
При отказе primary исправное зеркало может принять активную роль. Продолжение работы возможно, пока для каждого необходимого участка данных доступна рабочая копия. Потеря обеих копий одного участка уже означает недоступные данные. После восстановления экземпляры нужно вернуть в согласованное состояние.
Репликация использует журнал изменений WAL. Получение и применение WAL используют сеть, диски, CPU и память. После отказа хоста оставшиеся машины также принимают работу активированных зеркал, поэтому их нагрузка может вырасти.
Что резервирует standby coordinator
Standby coordinator защищает другую роль: каталог и точку управления кластером. Он получает изменения журнала coordinator и ожидает активации. В нормальном режиме это не второй активный coordinator, на который автоматически распределяется половина клиентских запросов.
При отказе основного coordinator standby активируют по процедуре восстановления. Резервирование coordinator не заменяет зеркала сегментов: каталог не содержит вместо них пользовательские таблицы. И наоборот, наличие всех mirror не даёт клиентам новую точку входа само по себе.
Зеркало и standby также не заменяют резервную копию. Если приложение ошибочно удалит корректные данные, репликация передаст это изменение резервным экземплярам. Восстановление после логической ошибки требует отдельной стратегии backup и проверки восстановления.
Что даёт shared-nothing
Shared-nothing означает, что у разных хостов собственные процессоры, память и диски. Они договариваются через сеть, а не читают одну общую память. Это позволяет наращивать совокупные ресурсы добавлением хостов, но требует распределения данных и балансировки работы.
Запрос ждёт завершения нужных ему исполнителей. Если один сегмент читает большую часть строк или его диск работает медленно, готовность остальных не завершит общий этап. Поэтому диагностика архитектуры начинается с вопроса «кто и сколько работы выполняет». Ключ распределения, пересылки, память и состояние хостов помогают ответить на него точнее, чем одно число сегментов в кластере.