Greenplum — аналитическая СУБД на основе PostgreSQL. Она хранит таблицы частями на нескольких сегментах и поручает им совместно выполнять SQL-запрос. Это позволяет использовать ресурсы нескольких серверов для чтения, соединений и расчётов над большими наборами данных. Пользователь подключается к одной базе и получает один результат.
Зачем распределять обработку
Представь запрос, которому нужно прочитать большой диапазон таблицы и посчитать сумму. На одном сервере чтение ограничивают его диски, память и процессоры. Можно усилить эту машину, но у вертикального масштабирования есть предел. Другой подход — разложить данные по нескольким серверам и дать каждому свою часть работы.
MPP, massively parallel processing, означает массово-параллельную обработку. В Greenplum один запрос выполняется несколькими исполнителями одновременно. Каждый читает доступную ему часть таблицы, применяет фильтры и делает локальные вычисления. Затем промежуточные результаты объединяются в общий ответ.
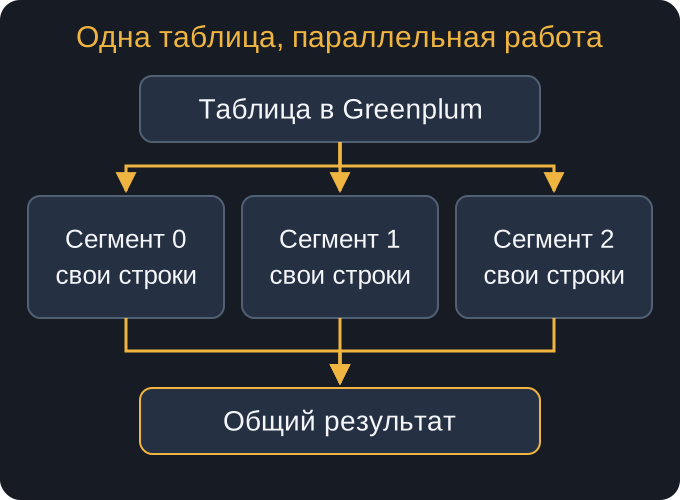
Для суммы не обязательно передавать все исходные строки в одно место: каждый сегмент может посчитать частичную сумму. Чем раньше уменьшается объём данных, тем меньше работы остаётся для сети и последующего объединения. Для JOIN условия сложнее: подходящие друг к другу строки сначала должны оказаться у одного исполнителя. Поэтому расположение данных влияет на стоимость запроса.
MPP не гарантирует ускорение любого SQL. Если почти все строки достались одному сегменту, остальные закончат раньше и будут ждать. Если запрос пересылает огромный промежуточный результат, ограничением может стать сеть. Добавление серверов помогает тогда, когда работа действительно делится и выигрыш превышает расходы на координацию.
Где Greenplum находится в системе
В хранилище данных Greenplum может принимать подготовленные выгрузки, хранить подробные данные и рассчитывать аналитические витрины. Инженер загружает очередной набор, проверяет его полноту, преобразует данные SQL-запросами, а BI-инструмент читает результат. Источник и расписание загрузки при этом находятся за пределами самой СУБД.
Greenplum полезен, когда запросы читают и соединяют значительные объёмы, а время измеряется стоимостью обработки всего набора. У приложения с большим числом коротких обращений по одному ключу другой профиль: там важны малая задержка каждой операции и высокая конкуренция коротких транзакций. Размер базы сам по себе ещё не определяет выбор системы.
Хранилище также не обязано держать всё внутри одной базы. Файлы могут оставаться в объектном хранилище, а отдельные таблицы — читаться через внешний доступ. Но внешний источник имеет собственную скорость, доступность и правила согласованности. Распределённая обработка не устраняет эти ограничения.
Что знакомо по PostgreSQL, а что добавляется
Таблицы, типы, фильтры, JOIN, агрегаты и транзакции остаются частью работы с SQL. Знакомство с PostgreSQL помогает читать запросы и понимать версии строк. При этом Greenplum — отдельная СУБД со своим распределённым исполнителем, оптимизаторами и средствами загрузки. Совпадение синтаксиса не означает совпадение физического плана.
Теперь у таблицы есть политика распределения: она определяет, на каких сегментах находятся строки. В плане появляются Motion — операции передачи данных между исполнителями. Помимо числа прочитанных строк важны их размещение, объём пересылки и самый загруженный сегмент.
Отдельно выбирают физическое хранение. Greenplum поддерживает обычное строковое heap и append-optimized хранение со строковой или колоночной организацией. Поэтому выражение «распределённая таблица» ещё ничего не говорит о том, лежат ли значения строки рядом и используется ли сжатие.
Как связаны темы модуля
Начнём с архитектуры: кто принимает запрос, где хранятся данные и какие экземпляры нужны для отказоустойчивости. Затем разберём распределение и JOIN: эти темы объясняют, почему одинаковый SQL может потребовать разного обмена по сети.
Партиции помогут ограничить читаемый период, а виды таблиц — выбрать организацию хранения. После этого путь загрузки и план запроса станут понятнее: можно будет проследить данные от файла до сегмента и от чтения до общего ответа. Обслуживание и ресурсные группы объяснят, почему корректный запрос иногда ждёт или расходует больше места, чем ожидалось.
Примеры с особенностями синтаксиса относятся к Greenplum 7. В старых материалах роль coordinator называется master, а часть DDL записана иначе. Если есть учебный кластер, в конце доступна отдельная практика: на нём можно увидеть настоящий gp_segment_id, план и Motion. Теория остаётся полезной и без подключения к стенду.