Распределение отвечает на вопрос: на каком сегменте хранится строка внутренней таблицы? От этого зависит не только объём данных на диске. Если строки, нужные одной операции, уже находятся вместе, сегмент выполнит её локально. Иначе плану понадобится пересылка по сети.
Распределение по ключу
Hash distribution использует значения указанных колонок: Greenplum хеширует ключ и определяет сегмент для строки. Для одной совместимой политики одинаковое значение полного ключа попадает на один сегмент. Разные значения могут попасть на тот же сегмент: соответствие не является взаимно однозначным.
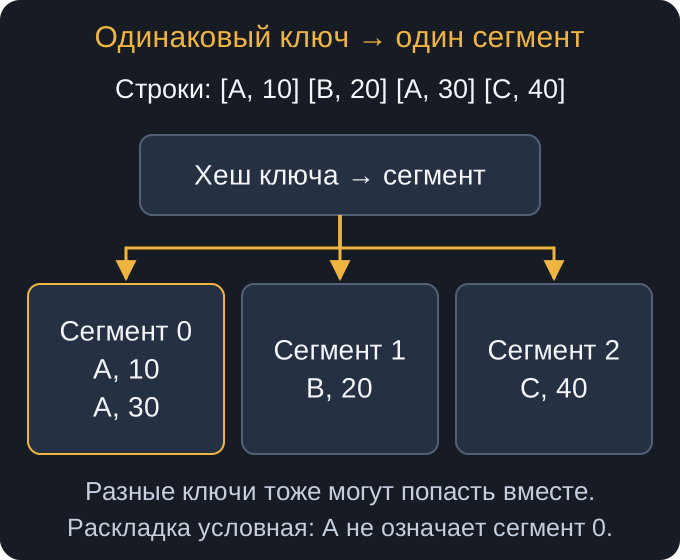
На схеме строки с A остаются вместе независимо от значения второй колонки. Если таблица связана с другой таблицей по этому ключу и обе распределены совместимо, исполнителю проще найти пары у себя. Точный номер сегмента заранее не выводят из буквы, числа или остатка от деления: размещение определяется хешированием и политикой кластера.
Политику записывают явно при создании таблицы. В Greenplum 7 окончание DISTRIBUTED BY (entity_id) задаёт ключ entity_id; DISTRIBUTED BY (entity_id, category_id) использует комбинацию двух значений. Это выбор физического размещения, он не объявляет ключ уникальным и не удаляет дубликаты.
Составной ключ может дать более разнообразный набор комбинаций. Но тогда одинакового entity_id недостаточно для совместного размещения: разные категории одной сущности могут храниться отдельно. JOIN только по первой части ключа уже не получает прежней гарантии локальности. Выбор проверяют по реальным запросам, а не по числу колонок в DDL.
Почему появляется перекос
Skew — неравномерность данных или работы между сегментами. Пусть шесть из восьми строк имеют один ключ X. Hash distribution обязана оставить эти шесть строк вместе. Остальные сегменты могут быстро обработать свои единичные строки и ждать перегруженного исполнителя.
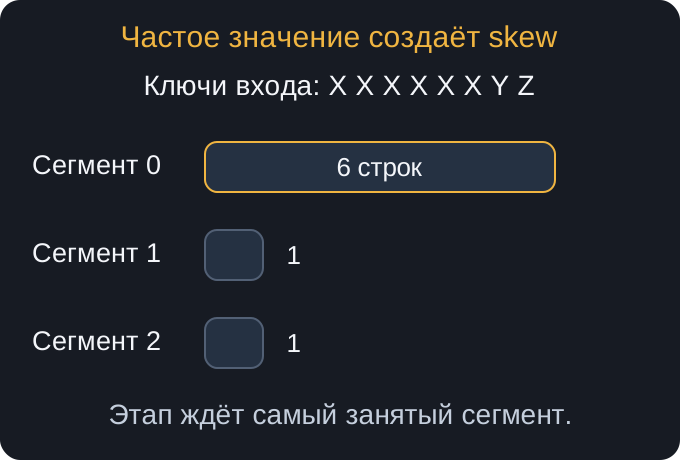
Частое значение, техническая заглушка или большое число NULL способны дать такой эффект. Важна частота полного ключа. Высокое количество различных значений само по себе не спасает, если половина таблицы всё равно приходится на одно из них. И наоборот, колонка с датой не «всегда плохая»: её пригодность зависит от числа дат, частот и профиля запросов.
Перекос хранения заметен уже по количеству строк и размеру данных на сегментах. Перекос выполнения может возникнуть позже. Например, равномерную таблицу отфильтровали до одного частого ключа или после JOIN резко выросло число совпадений на одном исполнителе. Поэтому равномерное исходное размещение — только первая проверка.
Random и replicated
Random distribution распределяет строки без закрепления одинакового бизнес-ключа за одним сегментом. Её выбирают, когда подходящего ключа пока нет или набор используется как промежуточный. Она может помочь распределить хранение, но не обещает идеально одинаковое число строк. Соединение по конкретной колонке обычно требует отдельного решения о перемещении.
Replicated distribution сохраняет полный набор таблицы на каждом primary. Тогда небольшой справочник доступен локально рядом с каждой частью большой таблицы. Это постоянные копии хранимых данных; Broadcast в плане, который разберём дальше, создаёт копии потока для конкретного запроса.
За replicated платят местом и записью всех копий. «Маленький справочник» оценивают по байтам, ширине строк, частоте обновлений и числу сегментов. Универсального предела в сто тысяч строк у этого принципа нет. Для большой широкой таблицы копирование на каждый primary легко окажется дороже пересылки нужной части в отдельных запросах.
| Политика | Что происходит со строками | Что учитывать |
|---|---|---|
| Hash | Полный ключ определяет сегмент | Частоты ключей и частые JOIN |
| Random | Нет гарантии совместного размещения по ключу | Стоимость последующей пересылки |
| Replicated | На каждом primary полный набор | Общий размер всех копий и запись |
Как выбирать и проверять ключ
Сначала смотрят на крупные запросы: по каким колонкам соединяются большие наборы, какие фильтры остаются после отбора, какие ключи встречаются особенно часто. Затем сравнивают варианты распределения. Хороший ключ сочетает приемлемую равномерность с полезным размещением для частых операций.
Измерение на кластере должно включать число строк по сегментам и фактический план характерного запроса. Скрытая колонка gp_segment_id помогает увидеть размещение обычной распределённой таблицы; она не предназначена для такого чтения replicated-таблицы. После фильтра и Motion смотрят уже на распределение работы исполнителей, а не только на исходную таблицу.
Наконец, ключ — компромисс для нагрузки в целом. Одно размещение редко делает локальными все соединения сразу. Перед изменением большой таблицы оценивают объём переноса, свободное место и выигрыш основных запросов. Причины Motion и условия совместимости распределения разбираем в следующем уроке.