Хранить файлы недостаточно. По пути объекта вида data/2026/09/part-004.parquet нельзя понять, что в нём лежит, кто его создал, какая версия схемы действует и можно ли использовать набор в отчёте. Для этого нужен каталог данных — описание наборов и их расположения. Каталог может быть отдельным сервисом, частью табличного формата или набором согласованных метаданных. Его задача — дать читателю понятный способ найти и правильно прочитать данные.
Какие метаданные нужны
| Группа | Пример вопроса |
|---|---|
| Происхождение | Из какой системы и какой поставки получены файлы? |
| Структура | Какие поля, типы, единицы и версия контракта действуют? |
| Организация | Какие файлы входят в таблицу, как она разбита на партиции? |
| Ответственность | Кто владелец набора и как сообщить об ошибке? |
| Доступ | Кто может читать данные и какие поля ограничены? |
| Качество | Когда набор обновлялся, какие проверки прошёл, известны ли пропуски? |
| История преобразований | Из каких входов и какой версией кода создан результат? |
Последнюю связь часто называют lineage — происхождением данных. Если число в витрине изменилось, lineage помогает пройти от результата к обработке и исходной поставке. Каталог хранит описание набора, а корректность данных проверяют при загрузке. Единицу «рубли» в описании поля сверяют с исходными значениями: ошибка в метаданных передаётся всем потребителям.
Каталог и схема чтения
Для CSV обычно нужно отдельно знать кодировку, разделитель, заголовок, типы и смысл пустых значений. Parquet хранит физическую схему внутри файла, но не объясняет, означает ли число рубли или копейки. Если часть файлов записана по старому контракту, каталог или связанные с ним правила должны помочь читателю выбрать совместимую версию и выполнить преобразование.
Полезно разделять физическую схему — типы и структуру файла — и предметный контракт — смысл полей, единицы, время действия и допустимые значения. Изменение одного без другого возможно: поле может остаться числовым, хотя его единица поменялась. Такое изменение особенно опасно, потому что запрос успешно выполнится и вернёт неправдоподобно большое или маленькое число.
Почему нужна версия опубликованного набора
Предположим, таблица за месяц состоит из десяти файлов. Пересчёт записывает новые десять, но прерывается после шестого. Если читатель ориентируется только на список объектов в каталоге хранения, он может увидеть смесь старой и новой версий. Надёжнее сначала записать файлы, проверить их и затем одним действием опубликовать новый список файлов таблицы. До публикации читатели работают со старым согласованным снимком.
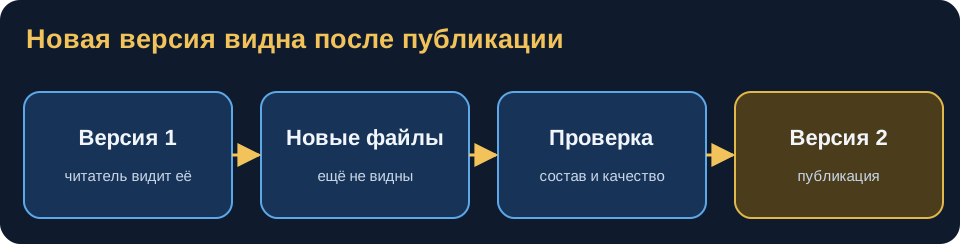
Табличные форматы поверх озера используют для такого управления метаданные и снимки. Например, Iceberg фиксирует список файлов, входящих в версию таблицы. Читатель получает согласованный список; новую версию публикуют после подготовки файлов. Parquet описывает содержимое отдельного файла, а не состав всей таблицы. Возможность прочитать старый снимок зависит ещё и от того, сохранены ли его файлы.
Версия нужна и для воспроизводимости. Если аналитик вчера получил число, а сегодня результат изменился, полезно знать снимок таблицы, версию модели и входные поставки обоих запусков. Иначе невозможно отличить исправление старых данных от смены формулы.
Iceberg и Trino выполняют разные роли
Apache Iceberg — открытый табличный формат. Он описывает схему, разбиение, снимки и метаданные, по которым движок определяет состав таблицы. Файлы данных при этом могут оставаться Parquet или ORC. При записи сначала создают новые файлы и метаданные, затем согласованно публикуют новую версию таблицы; читатель работает с выбранным снимком. Старые версии доступны, пока сохранены нужные метаданные и файлы.
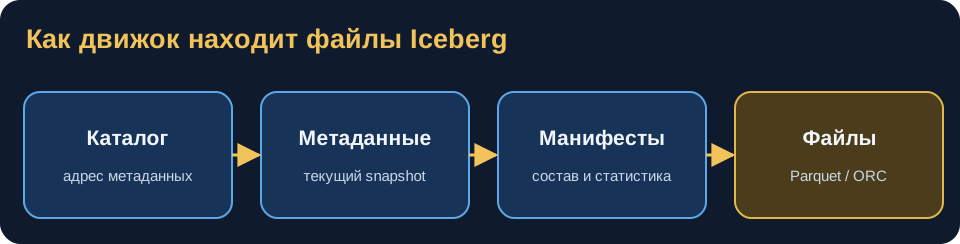
Путь чтения состоит из нескольких небольших указателей. Каталог сообщает расположение актуального JSON-файла метаданных таблицы. В нём указан текущий snapshot. Снимок ведёт к manifest list — списку манифестов. Каждый manifest перечисляет файлы данных и статистику по ним. Движок использует фильтр запроса и эту статистику, чтобы пропустить заведомо ненужные файлы, затем читает нужные колонки в Parquet. Так выбор одного дня не требует сначала открыть каждый файл озера. Возможность пропуска зависит от разбиения, статистики и самого фильтра; она не гарантирует быстрый запрос при любой структуре файлов.
Trino — распределённый SQL-движок. Он получает описание таблицы через коннектор и каталог, читает нужные файлы, выполняет фильтры, соединения и агрегаты. Trino не является самим объектным хранилищем или файловым форматом. Для таблицы Iceberg каталог помогает найти актуальные метаданные, Iceberg определяет её состояние, Parquet — устройство отдельных файлов, а Trino выполняет запрос.
Поэтому «перевести CSV в Parquet» и «создать таблицу Iceberg» — разные операции. В первом случае меняется формат файлов, во втором появляется управление таблицей как согласованным набором. Возможности изменения данных зависят также от версии формата и поддержки конкретного движка.
Минимальный рабочий контракт набора
Для нового набора зафиксируйте имя и назначение; владельца; источник; расписание или способ поступления; ключ и зерно записей; схему и единицы; правила обновления и удаления; права доступа; ожидание по свежести; идентификатор опубликованной версии. Это звучит бюрократично, пока файлов десяток. При сотнях источников именно такой контракт позволяет другому инженеру использовать данные без догадок.
Попробуйте на данных
В упрощённом учебном каталоге lake_versions хранит версии набора, а lake_snapshot_files связывает версию с файлами. Для каждого набора здесь ровно одна версия помечена published; реальный Iceberg выбирает текущий снимок через указатель в метаданных. Читатель берёт только опубликованную версию:
SELECT dataset, version
FROM lake_versions
WHERE status = 'published'
ORDER BY dataset;
В заданиях найдите её файлы и проверьте, что они существуют. Это маленькая модель механизма Iceberg: метаданные указывают на согласованный снимок, а файлы Parquet хранят строки. SQL-движок вроде Trino читает выбранный снимок; каталог помогает найти набор. Ни один из компонентов не проверит смысл показателя за автора данных.
Верните dataset и version только опубликованных наборов, по dataset.