Выбор способа обработки начинается с требований к свежести и исправлению результата. Ежедневный проверенный отчёт и сигнал о событии через секунды могут опираться на один источник, но требуют разных обещаний потребителю. Ни batch, ни streaming не делают данные правильными автоматически: оба способа должны учитывать повторы, опоздания и смену правил.
Пакетная обработка
Batch собирает ограниченный набор входа и обрабатывает его как одну работу. Это может быть день, час или список файлов, поступивших до контрольного времени. После расчёта результат проверяют и публикуют. Если обнаружилась ошибка правила, затронутый период пересчитывают из сохранённого входа.
Пакетный процесс не обязательно запускается раз в сутки. Он может стартовать каждые несколько минут. Важнее то, что у запуска есть определённая граница данных, версия кода и момент публикации. Такие границы облегчают сверку и воспроизведение отчёта.
Потоковая обработка
Streaming читает события по мере поступления и обновляет состояние или выдаёт результат с малой задержкой. Движок должен помнить позицию чтения и управлять состоянием расчёта. При сбое событие может быть прочитано повторно, поэтому применённая операция должна быть идемпотентной или иметь механизм дедупликации.
Время события и время его получения не всегда совпадают. Сообщение может задержаться в сети. Для агрегата «за последнюю минуту» надо определить, до какого момента ждать опоздавшие события, что делать с более поздними и когда считать окно закрытым. Результат, показываемый сейчас, часто предварительный; это должно быть понятно читателю.
Поток не всегда быстрее и дешевле пакета. Он требует постоянно работающих компонентов, хранения состояния, контроля отставания и обработки изменений схемы. Если результат нужен к утру, пакетная схема может быть проще и надёжнее.
Lambda: два пути к одному результату
Lambda-архитектура использует две реализации расчёта: пакетную по сохранённой истории и быструю по новым событиям. Слой выдачи объединяет их результаты. Быстрый путь даёт свежесть, а пакетный периодически пересчитывает проверенную историю.
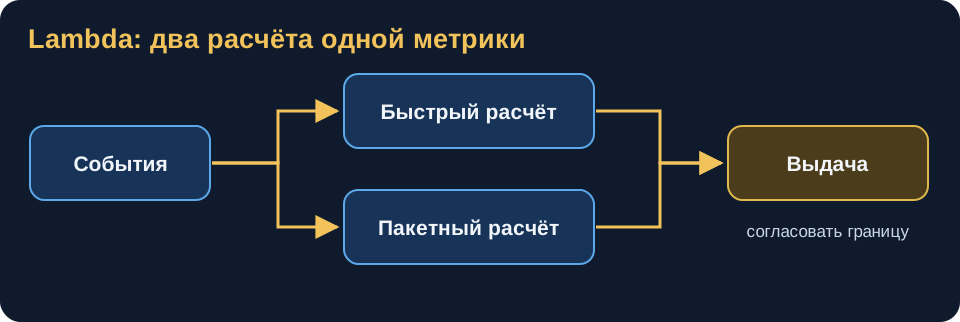
Главная сложность — правильно объединить покрытия. Если пакетный результат включает события до 12:00, быстрый должен начинаться после согласованной границы. Иначе часть событий посчитается дважды или потеряется. При обновлении пакета эту границу сдвигают. Кроме того, два алгоритма одной метрики должны одинаково трактовать отмены, дубли и поздние события.
Даже если диапазоны не пересекаются, нельзя бездумно сложить любые агрегаты. Например, один человек мог быть активен до и после 12:00. Сумма двух отдельных количеств уникальных людей посчитает его дважды. Для точного результата нужны множества идентификаторов или совместимые состояния агрегата.
Kappa: один потоковый расчёт с повтором
В Kappa-архитектуре события сохраняют в журнале, а представление для чтения строит один потоковый алгоритм. Когда правило меняется, обработчик может перечитать сохранённую историю и построить новое представление. Пакетной реализации той же метрики нет.
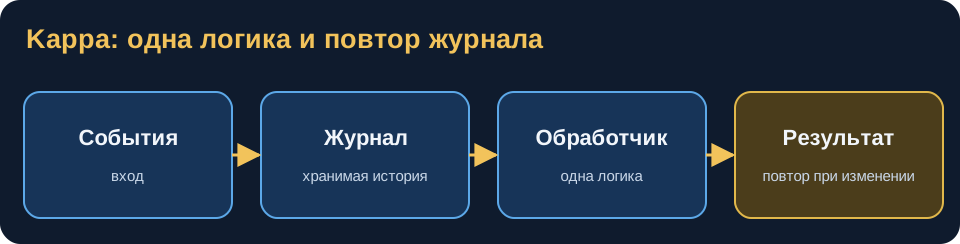
Возможность повтора зависит от срока хранения и объёма журнала. Если требуется пересчитать год, а события доступны только неделю, одного потока недостаточно: нужен архив или другой надёжный источник истории. Перед переключением читателей на новое представление проверяют, что повтор завершён и результат согласован. Повторное чтение само по себе не исправит ошибочный порядок событий или правило дедупликации.
Kappa не запрещает отдельные пакетные задачи в компании. Речь только об отсутствии двух независимых реализаций одного и того же расчёта. Если ежедневный отчёт и оперативный сигнал отвечают на разные вопросы, их не нужно искусственно объявлять Lambda.
| Требование | О чём спросить до выбора |
|---|---|
| Свежесть | Через сколько секунд, минут или часов нужен результат? |
| Исправления | Как поздние события и отмены меняют уже опубликованные периоды? |
| Повтор | Доступен ли исходный набор для пересчёта всей нужной истории? |
| Проверка | Как сверить результат с источником и безопасно опубликовать новую версию? |
| Сложность | Сможет ли команда поддерживать два алгоритма одной метрики и границу между ними? |
Начните с самого простого режима, выполняющего требования. Две красивых схемы не оправдывают два постоянных конвейера, если потребителю достаточно проверенного расчёта раз в час.
Объём данных и запас мощности
Объём витрины описывают хотя бы двумя числами: количество строк на выбранном зерне и физический размер в системе хранения. При оценке роста учитывают новые объекты и события, срок хранения, частоту снимков и число исторических версий. Дневной снимок 100 000 объектов за 365 дней даёт 36,5 миллиона строк; это уже другой объём, чем текущий справочник тех же объектов.
Первую оценку получают как «ожидаемые строки × средний размер строки», а физический размер проверяют на репрезентативной загрузке. На него влияют типы полей, сжатие, индексы, метаданные, копии и особенности движка. Отдельно нужен запас на staging, сохранённый вход, пересчёт рядом с прежней версией и временные данные запросов. Поэтому размер готовой таблицы не равен всей необходимой ёмкости платформы.
Если вход внезапно вырос в пять раз, сначала сравнивают длительность и объём каждого этапа: извлечение, передача, разбор, запись, соединения и публикация. Смотрят процессор, чтение и запись диска, сеть, очереди и самые медленные части распределённого расчёта. Spill означает перенос промежуточных данных на диск, когда рабочей памяти недостаточно; он может позволить завершить расчёт, но добавляет чтение и запись. Сам факт spill ещё не указывает, почему памяти не хватило.
После измерения выбирают меру под узкое место: сократить повторное чтение инкрементом, читать нужные колонки и разделы, устранить размножение строк, объединить мелкие файлы, изменить распределение или добавить ресурсы. Больше параллельных задач не ускорит перегруженный источник или диск. Если требуемая свежесть и объём не помещаются в доступные ресурсы, с потребителем согласуют меньшее покрытие, детализацию или более позднюю публикацию, показывая измерения и цену каждого варианта.
Попробуйте на данных
В delivery_events у события отдельно записаны время возникновения и время получения. По этой разнице можно увидеть, какой результат опоздает к пакетной границе:
SELECT event_id, event_time, arrived_at
FROM delivery_events
WHERE arrived_at > event_time + interval '1 hour'
ORDER BY event_id;
Задания проверяют задержку, пересчёт позднего периода и подсчёт уникальных клиентов без двойного счёта между окнами. Именно такие условия, а не название архитектуры, определяют сложность расчёта.
Найдите события, которые поступили более чем через час после возникновения. Верните event_id, event_time, arrived_at по event_id.