Файловые форматы решают разные задачи. Текстовый файл удобно получить от внешней системы и проверить глазами. Большую таблицу, из которой постоянно читают две-три колонки, выгоднее хранить в формате, позволяющем не открывать остальные поля. В Data Lake один и тот же набор может существовать в исходном и подготовленном виде.
{"sensor_id":"s1","observed_at":"2026-09-01T09:14:00Z","temperature_c":21.4}JSON Lines хранит по одному JSON-сообщению в строке. Его просто дописывать, смотреть глазами и принимать с меняющимся набором полей. Цена — объём повторяющихся имён, разбор текста при каждом чтении и неоднозначность типов, если источник прислал число строкой. JSON Lines удобен в raw, но повторный анализ большого архива бывает дорогим. Обычный JSON может быть и одним большим массивом; для потоковых поставок граница записей в JSON Lines часто удобнее.
Строковые и колоночные форматы
В строковом представлении значения одной записи находятся рядом. Чтобы обработать событие полностью — например, проверить координаты вместе с кодом ошибки, — это естественно. В колоночном представлении значения battery_pct множества событий лежат рядом; запрос, которому нужен только заряд, может не читать фотографию, длинное описание и другие поля. Parquet и ORC — колоночные файловые форматы; они хранят метаданные и блоки значений так, чтобы движок мог выбирать колонки и иногда пропускать группы строк по статистике. Возможность пропуска зависит от записанных метаданных, фильтра и реализации читателя, а не гарантируется одним расширением файла.
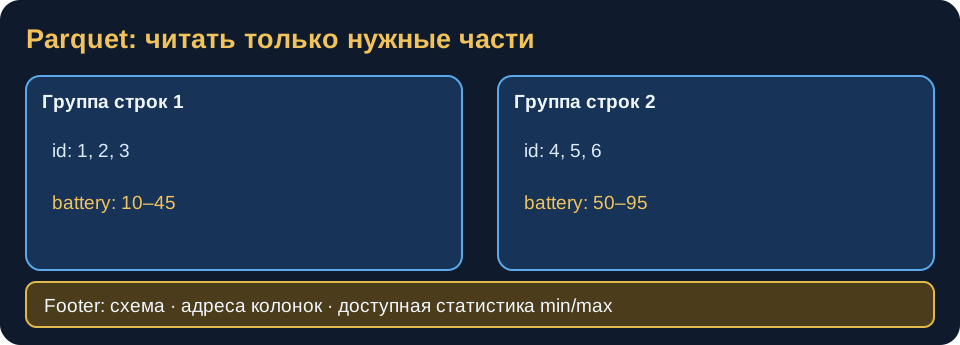
Parquet устроен подробнее, чем просто «колонки вместо строк». Файл делится на row groups — группы строк. В каждой группе есть column chunk — отдельный фрагмент для каждой колонки; внутри фрагмента значения записаны pages, страницами. На схеме две группы строк; для каждой показаны отдельные значения id и battery.
| Уровень | Что содержит | Для чего полезен |
|---|---|---|
| Файл | Группы строк и метаданные в конце | Узнать схему, расположение групп и доступную статистику |
| Группа строк — row group | Один диапазон записей | Пропустить группу целиком, если фильтр не может найти в ней совпадений |
| Фрагмент колонки — column chunk | Значения одной колонки в одной группе | Прочитать battery_pct, не загружая другие колонки этой группы |
| Страница — page | Порцию значений внутри фрагмента | Сжимать и декодировать данные порциями; иногда пропускать их по дополнительному индексу |
В конце файла находится footer: схема, число строк, адреса фрагментов колонок, размеры и доступная статистика. Читатель получает эти метаданные и решает, какие части файла нужны запросу. Статистика min/max относится к фрагменту колонки в группе строк, а не к каждой строке отдельно. Индекс страниц может дать более тонкий пропуск, но он необязателен и поддерживается не всеми файлами и движками.
ORC решает схожие аналитические задачи, но устроен иначе. Файл ORC делится на stripes — крупные полосы записей. Внутри полосы значения колонок хранятся отдельными потоками; есть индексы и статистика, а в конце файла — метаданные. Если условие запроса несовместимо с диапазоном значений полосы, читатель может пропустить её. Аналогия с Parquet помогает: row group и stripe оба позволяют работать с частью большого файла, но их внутренний формат различается. Ни Parquet, ни ORC сами по себе не определяют, какие файлы входят в текущую таблицу, как атомарно обновить набор или кому он доступен.
| Формат | Где часто удобен | Что проверить перед выбором |
|---|---|---|
| CSV | Простая выгрузка фиксированных полей, обмен с внешней системой | Разделитель, кавычки, кодировка, NULL, дата и типы не очевидны |
| JSON / JSON Lines | События с вложенными и меняющимися полями | Версии протокола, типы, объём, частичный или повреждённый файл |
| Avro | Передача структурированных записей со схемой, потоковые события | Где хранится схема, совместимость версий, кто её меняет |
| Parquet | Частые выборки отдельных колонок и агрегаты | Размер файлов и групп строк, типы, статистика, поддержка движком |
| ORC | Аналитическое колоночное хранение | Поддержка нужным движком, статистика и конкретный профиль запросов |
Avro — формат с явной схемой записи и механизмами сопоставления схемы записи и чтения. Если к событию добавили необязательное поле temperature, читатель старой версии может продолжать обрабатывать известные поля при корректно заданной совместимости. Но наличие схемы не объясняет бизнес-значение: battery=72 всё ещё может означать проценты, а 0.72 — долю. Единицы и версия протокола остаются частью контракта.
Как выбирать для одной цепочки
Для поступления телеметрии можно сохранять исходный JSON Lines или Avro, если источник уже передаёт события по схеме. После проверки версии протокола построить Parquet с battery_pct, event_time_utc и vehicle_id. Аналитик, считающий средний заряд по дням, читает только нужные колонки. Инженер, выясняющий ошибку конкретного устройства, при необходимости возвращается к исходному сообщению. Фотографии остаются отдельными объектами; в таблице достаточно ключа объекта и описания связи с событием.
Для маленькой выгрузки в тысячу строк CSV может быть вполне достаточен. Нет смысла превращать любой файл в Parquet только потому, что проект называется Data Lake. Но при регулярных сканированиях миллиардов записей разница между чтением всех полей текста и нужных колонок становится существенной.
Как пропустить ненужные файлы
Представим подготовленные события за год, разложенные по дню: day=2026-09-01/part-001.parquet, day=2026-09-02/part-001.parquet и так далее. Запрос за 1 сентября может выбрать только соответствующий раздел — партицию — и не открывать файлы других дней. Это экономит чтение до того, как Parquet начнёт выбирать нужные колонки внутри файла. Но если запрос фильтрует по дате события, а разделы названы по дате загрузки, он может пропустить нужное позднее событие. Значение партиции и её смысл должны быть описаны.
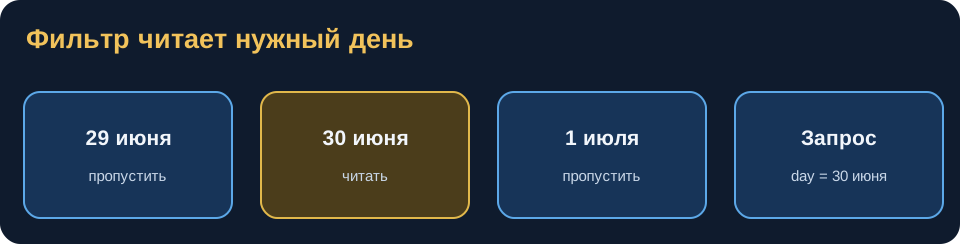
Теперь соединим уровни на одном запросе. Предположим, в файле за 1 сентября две группы строк: у первой battery_pct от 10 до 45, у второй — от 50 до 95. Ищем средний заряд среди событий с зарядом не ниже 70%.
SELECT AVG(battery_pct) AS avg_battery_pct
FROM telemetry
WHERE day = DATE '2026-09-01'
  AND battery_pct >= 70;
Здесь day — колонка раздела, соответствующая каталогу. Мы предполагаем, что раздел построен по дате события, а не по дате загрузки: иначе позднее событие могло попасть в другой каталог.
| Шаг | Что исключается | Откуда берётся решение |
|---|---|---|
| Выбор раздела | Файлы за другие дни | day = 2026-09-01 и расположение файлов по дням |
| Пропуск группы строк | Первая группа за 1 сентября: её максимум 45 меньше 70 | max(battery_pct) в метаданных группы |
| Выбор колонок | Координаты, текст ошибки и другие поля второй группы | Запрос использует только battery_pct; day уже известен из раздела |
| Проверка строк | Значения 50–69 во второй группе | После чтения оставшейся колонки применяется точный фильтр |
Границы min/max помогают решить, где точно нет подходящих значений; они не заменяют проверку каждой прочитанной строки. Пропуск может не сработать, если статистику не записали, типы не согласованы или конкретный читатель не умеет применить фильтр. Выбор файлов относится к устройству набора данных, а выбор колонок и статистика — к содержимому Parquet-файла.
Другая крайность — по одному файлу на каждое событие. На открытие и учёт тысяч маленьких файлов может уйти больше времени, чем на чтение их данных. Тогда несколько маленьких частей объединяют в более крупные, сохраняя ту же логическую таблицу. Универсального размера файла нет: он зависит от объёма, способа записи и движка чтения.
Когда меняется схема
Если новая версия устройства добавила temperature_c, старые файлы не обязаны внезапно получить эту колонку. Читатель может трактовать отсутствие как NULL, если это допустимо для задачи. Но если поле battery осталось числом, а его единица изменилась с доли на процент, автоматическое объединение схем не спасёт. Нужны версия протокола и явное преобразование: 0.72 и 72 должны стать одним battery_pct=72. Исходные файлы позволяют пересчитать набор после исправления правила.
Попробуйте на данных
lake_files описывает файлы, которые лежат в разных зонах и форматах. Для запроса по двум колонкам и одной дате сначала отберите нужный раздел и подготовленную зону:
SELECT object_key, format, size_bytes
FROM lake_files
WHERE zone = 'prepared' AND partition_day = '2026-06-30'
ORDER BY object_key;
SQL здесь читает метаданные, а не содержимое Parquet. Задания помогут заметить много мелких файлов и выбрать входы для конкретного чтения. CSV не становится плохим форматом во всех случаях: решение зависит от объёма и способа использования.
Для чтения подготовленных данных 30 июня выберите только Parquet-файлы этой даты. Верните object_key и size_bytes по ключу.