Data Lake, или озеро данных, — подход к хранению больших наборов данных в исходном либо близком к исходному виде, чтобы затем использовать их для разных задач. В озеро могут поступать выгрузки таблиц, события приложения, ответы API, логи, изображения и другие файлы. Не нужно заранее превращать каждую поставку в одну общую аналитическую таблицу. Но озеро — не просто папка, куда без разбора складывают всё подряд: пригодность данных зависит от описания, правил доступа и обработки.
Идея появилась из практической проблемы. Хранилища с заранее согласованной моделью хорошо обслуживают известные отчёты. Когда данных становится много и команды ещё не знают всех будущих вопросов, дорого или невозможно сразу спроектировать витрину под каждый новый формат. Объектное или распределённое файловое хранилище позволяет сначала надёжно принять набор, сохранить его происхождение, а модель для конкретного использования подготовить позже.
Из чего состоит озеро
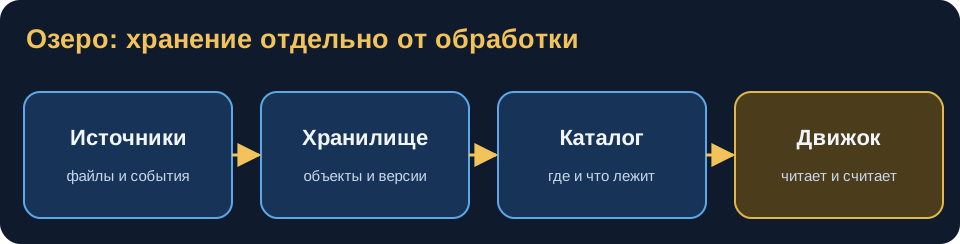
На схеме важно различать роли. Amazon S3 — сервис объектного хранения; совместимый с ним API поддерживают и другие хранилища. HDFS — распределённая файловая система из экосистемы Hadoop. Spark — вычислительный движок, который читает данные, преобразует их и записывает результат. Каталог описывает наборы, схемы и расположение файлов. Ни Spark, ни Hadoop не являются обязательной «базой внутри озера». Конкретный стек зависит от инфраструктуры.
Источниками могут быть PostgreSQL через периодическую выгрузку или CDC, CRM через API, события сайта через поток сообщений и файлы партнёра через загрузку объектов. Все они могут оказаться в одном контуре хранения, но договорённости о доступе и содержимом у них различаются.
Озеро полезно, когда у данных пока несколько возможных применений. Например, технические логи сначала нужны для разбора сбоя, позже — для оценки времени ответа сервиса. Если при первой загрузке оставить только дневное среднее, отдельные медленные запросы уже не изучить. Сохранённый вход даёт возможность построить новую обработку. Плата за эту гибкость — обязанность описывать данные и следить за тем, кто и как их использует.
Что происходит после поступления файла
На приёме фиксируют источник, время, диапазон данных, версию контракта и идентификатор поставки. Исходный JSON или CSV полезно оставить, если требуется повторная обработка. Затем проверяют структуру, разбирают типы, удаляют технические повторы, приводят единицы и создают подготовленный набор. Для аналитического чтения большой таблицы его нередко записывают в Parquet или ORC.
Условный путь может выглядеть так:
| Состояние | Что хранится | Для чего пригодно |
|---|---|---|
| Получено | Неизменённые файлы и метаданные поставки | Повторить обработку, доказать происхождение |
| Разобрано | Проверенная схема, типы, ошибки отдельно | Объединять и преобразовывать |
| Подготовлено | Согласованные ключи и правила расчёта | Анализировать и строить витрины |
Эти состояния иногда называют bronze, silver и gold. Имена удобны, но не являются универсальным стандартом. В одной организации silver уже содержит общие идентификаторы, в другой — только техническую проверку. Смотрите контракт набора, а не цвет слоя.
Если в источнике поле amount сегодня означает рубли, а через полгода стало означать копейки, один и тот же JSON-тип не спасёт отчёт. Нужно знать версию схемы и единицу для каждого периода. Schema-on-read означает, что интерпретацию часто применяют при чтении исходного набора, а не до его сохранения. Это даёт гибкость, но не отменяет определения полей. Без них два читателя одного файла могут получить разные результаты.
Где лежит набор и как его находят
В объектном хранилище файл обычно адресуют ключом внутри бакета. Условный ключ raw/source/events/load_date=2026-04-14/part-001.json сообщает, из какого источника и какой поставки он пришёл. Это соглашение команды, а не встроенная таблица SQL. Ключ load_date здесь означает дату приёма; дата самого обращения может быть другой. Если назвать оба поля просто date, позже легко прочитать не тот период.
Каталог связывает логическое имя набора с расположением файлов, схемой и владельцем. Вычислительный движок обращается к каталогу, получает описание и читает файлы из хранилища. Сам бакет не проверит уникальность бизнес-ключа или смысл поля времени события. Эти проверки выполняют при обработке и публикации набора.
| Набор | Где хранить исходник | Что подготовить для чтения |
|---|---|---|
| Ответ CRM API за день | JSON вместе с временем запроса и версией ответа | Таблицу с разобранными полями и ошибками разбора отдельно |
| События приложения | Файлы с границами поставки или позициями потока | Колонки с типами, временем события и признаком дубля |
| Изображения оборудования | Оригинальные объекты с правами доступа и сроком хранения | Метаданные и результаты анализа, доступные через каталог |
Файлы не стоит бесконечно дробить на части по несколько килобайт: чтение тысячи мелких объектов создаёт много операций открытия и планирования. Но и один гигантский файл неудобен для параллельной обработки и точечного пересчёта. Размер и разбиение выбирают под реальный способ чтения, затем наблюдают число файлов, время запроса и стоимость операций. Отдельно в теме о форматах разберём, чем разбиение набора отличается от внутреннего устройства Parquet.
Исправление данных без потери исходного входа
Предположим, партнёр повторно прислал файл за 14 апреля с исправленными записями. Если молча перезаписать объект по прежнему ключу, будет трудно доказать, какой вариант участвовал во вчерашнем расчёте. Надёжнее различать поставки, сохранять их идентификаторы и явно выбирать опубликованную версию подготовленного набора. Срок хранения старых входов при этом задают отдельно: сохранять персональные данные бесконечно нельзя только ради удобства пересчёта.
Полезная сверка на такой границе — число полученных файлов и строк, число разобранных строк, число ошибок, доля дублей и свежесть последней поставки. Если файл существует, но половина строк не прошла проверку схемы, успешная запись в S3 ещё не означает успешную загрузку данных.
Чем Data Lake отличается от DWH
DWH обычно организуют вокруг согласованных сущностей, истории и известных аналитических вопросов. Data Lake позволяет экономно сохранять большие объёмы разнородного входа и использовать его позже. В DWH читатель ожидает подготовленную таблицу с определённым смыслом. В озере исходный файл может быть ещё непригоден для отчёта, пока его не обработали.
| Вопрос | DWH | Data Lake |
|---|---|---|
| Что кладут на вход | Данные проходят подготовку к согласованной модели; raw-слой тоже возможен | Можно принять разнородные файлы до окончательной модели |
| Как читают | Обычно через таблицы с известным контрактом | Через файлы, каталог, SQL-движок или вычислительный фреймворк |
| Что даёт ценность | Повторяемый аналитический ответ и общие определения | Сохранение данных для разных будущих обработок |
| Где риск | Потерять нужную деталь при раннем преобразовании | Накопить непрозрачные файлы без описания и владельца |
Это не противоположные коробки. Исходные данные могут лежать в озере, а подготовленные витрины — в DWH. Можно также строить аналитические таблицы прямо поверх файлов. Разницу определяют договорённости о качестве и назначение набора, а не расширение файла.
Почему озеро может стать «болотом»
Data Swamp — озеро, в котором данные формально сохранены, но почти невозможно понять, что использовать. Типичные признаки: каталога нет, одни и те же файлы загружены много раз, владелец набора неизвестен, схема изменилась без версии, права доступа выдаются вручную, устаревшие наборы не помечены. Стоимость хранения может быть невысокой, а стоимость поиска и проверки — огромной.
Поэтому для каждого набора нужны минимум: имя и назначение, источник и владелец, расписание или способ поступления, формат и версия схемы, правила доступа, срок хранения, признаки свежести и качества. Полезно сохранять lineage — связь результата с входными наборами и версией обработки. Если показатель изменился, эта цепочка помогает найти причину.
Отдельно продумывают публикацию. Если пересчёт записывает несколько файлов, читатель не должен увидеть только половину нового результата. Для этого используют согласованный список файлов или версию таблицы. Подробности каталога и табличных форматов будут дальше.
Где здесь Lakehouse
Lakehouse соединяет файловое хранение озера с возможностями аналитической таблицы: управляемыми версиями, схемой и согласованным чтением. Например, Apache Iceberg хранит метаданные о том, какие файлы входят в опубликованный снимок таблицы. SQL-движок читает этот снимок как таблицу, хотя сами данные лежат в файлах. Качество и смысл полей по-прежнему определяет команда, которая готовит набор.
Для первого проекта полезнее ответить на простые вопросы: зачем сохранять исходники, кто сможет их найти, чем будут обрабатываться файлы и как понять, какой результат опубликован. Если ответов нет, покупка ещё одного инструмента не создаст работающий Data Lake.
Попробуйте на данных
В песочнице lake_objects — небольшой реестр файлов. Это не настоящая S3 и не SQL-таблица поверх всех файлов: таблица хранит ключ объекта, идентификатор поставки batch_id, состояние, размер и контрольную сумму checksum. Совпадающая сумма у двух сырых объектов помогает заметить повторную доставку содержимого. Начните с поиска входа:
SELECT object_key, batch_id, bytes
FROM lake_objects
WHERE dataset = 'support' AND state = 'raw'
ORDER BY object_key;
В заданиях найдите состав поставки, неразобранные входы и повторную доставку. Так становится видно, зачем озеру нужны метаданные, даже если байты файлов уже надёжно записаны.
Найдите сырой вход support из поставки b1. Верните object_key и bytes по ключу объекта.