Непрерывный перенос между внешней системой и Kafka требует чтения, преобразования, записи и сохранения позиции. Эти действия можно реализовать собственным приложением или connector в Kafka Connect. Готовый connector сокращает часть своего кода, но формат данных и поведение при сбое всё равно нужно выбрать.
Source приносит данные, sink забирает
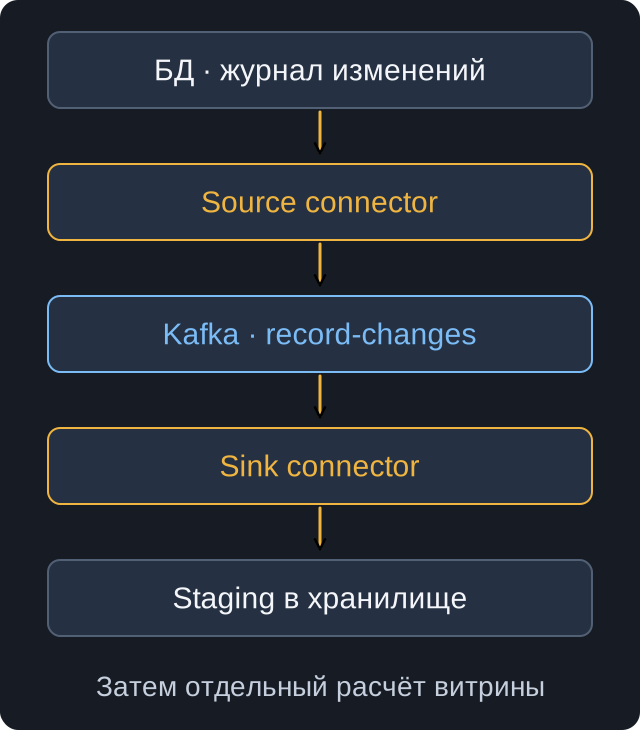
Kafka Connect — framework для работы интеграционных connector. Source connector читает внешнюю систему и публикует записи в Kafka. Sink connector читает Kafka и записывает внешний приёмник. Эти направления относятся к Kafka: «source» является источником для неё, а не универсальным названием любого входа шага.
Журнал БД → source connector → record-changes
record-changes → sink connector → staging в хранилище
staging → расчёт витрины → отчёт
В этом маршруте Kafka хранит доступную историю и разделяет темпы участников. Connector выполняет конкретную интеграцию: PostgreSQL, объектное хранилище или другой приёмник. Нужный plugin должен поддерживать выбранную систему и версию. Connect не превращает любую неизвестную систему в готовый endpoint переноса.
Собственный consumer уместен, если нужна особая логика, которую connector не выражает. Готовый plugin полезен, когда его возможности и гарантия переноса подходят. В обоих случаях останутся сериализация, доступы, позиция восстановления и сверка результата.
Worker запускает connector и его tasks
Worker — процесс Connect. Connector описывает интеграцию и создаёт tasks, единицы работы. Worker запускает tasks и обеспечивает общий жизненный цикл. Несколько distributed workers распределяют задачи между собой и меняют назначение при смене состава.
tasks.max задаёт верхнюю границу числа задач, а не обещание создать столько исполнителей и ускорить перенос во столько раз. Источник может иметь только одну последовательность чтения. У sink параллелизм ограничен партициями входа и возможностями plugin. Один sink task способен получить несколько партиций.
В standalone-режиме работает один локальный процесс; source offsets могут сохраняться в файле. В distributed-режиме Connect хранит конфигурации, source offsets и статусы в служебных топиках. Это отдельный набор данных Connect. Позиция источника, например позиция журнала БД, отличается от consumer commit в __consumer_offsets.
Если source получил изменение на позиции БД 900 и записал его в партицию Kafka с offset 12, числа описывают разные журналы. Нельзя вычитать 900 из 12 для расчёта lag. Нужно смотреть, насколько source отстаёт от журнала базы, и отдельно насколько sink отстаёт от Kafka.
Конфигурация связывает plugin и формат
Ниже пример тела конфигурации sink для строкового учебного потока. FileStreamSink пишет строки в файл, а не в аналитическую базу. key.converter и value.converter переводят байты Kafka в представление Connect.
{
  "name": "records-file",
  "config": {
    "connector.class": "org.apache.kafka.connect.file.FileStreamSinkConnector",
    "tasks.max": "1",
    "topics": "records",
    "file": "/tmp/records.txt",
    "key.converter": "org.apache.kafka.connect.storage.StringConverter",
    "value.converter": "org.apache.kafka.connect.storage.StringConverter"
  }
}
Для Kafka 4.3.1 примерный plugin поставляется в connect-file-4.3.1.jar, который надо явно включить в plugin.path worker. Сам worker также требует настройки брокеров и режима хранения. Поэтому этот JSON является описанием одной интеграции, а не полной инструкцией запуска.
Строковый converter оставляет JSON строкой. Он не извлечёт entity_id и не проверит схему записи. Если connector ожидает структурированную запись, нужно согласовать соответствующий converter и сериализацию producer. Для Avro с Registry обычно используется отдельный converter, который знает этот протокол; имя и настройка зависят от установленного plugin.
CDC получает изменения из журнала базы
Change Data Capture, CDC, переносит изменения источника: вставку, обновление, удаление. Чтение журнала базы позволяет замечать и удаления, которые легко потерять при опросе WHERE updated_at > checkpoint. CDC-source часто сначала делает согласованный снимок, затем продолжает с позиции журнала.
Для одной строки с ключом 17 нормализованный пример CDC выглядит так:
snapshot: entity_id=17, version=1, payload=a
update:   entity_id=17, version=2, payload=b
delete:   entity_id=17, version=3, deleted=true
Snapshot даёт начальное состояние, а последующие изменения его обновляют. Приёмник должен отличать строки снимка от новых вставок после запуска CDC. Если считать каждую строку snapshot новой вставкой, начальная загрузка существующих данных ошибочно увеличит счётчик новых изменений.
Реальный CDC connector имеет свой envelope, операции и метаданные источника. Например, удаление может передаваться записью об операции и отдельным tombstone. Настроить key и правильно применить delete в приёмнике столь же важно, как прочитать update. Чтение журнала требует прав, удержания исходной истории и контроля позиции: если журнал базы ушёл вперёд и удалил нужную часть, одной команды restart недостаточно.
Граница интеграции требует проверки
Sink может успеть записать пачку и завершиться до сохранения позиции. Повтор после восстановления тогда касается уже записанного результата. Устойчивость зависит от connector и приёмника: уникальных ключей, upsert, версий или согласованного checkpoint. Наличие Connect не устанавливает EOS во внешней базе автоматически.
Отдельные connector поддерживают более сильные гарантии при конкретных настройках. Нужно проверить документацию именно plugin, формат результата и процедуру восстановления. Для source exactly-once тоже требуется поддержка connector и соответствующего режима framework.
Статус worker RUNNING показывает работу процесса, но конкретный task может быть FAILED. Даже работающий task может отставать. После изменения конфигурации полезно сверить исходные изменения, записи Kafka и фактический результат: количество уникальных фактов, пропущенные ключи, последние версии и удалённые сущности. Lag оценивает продвижение, а сверка проверяет содержимое.
Самопроверка
Раздели в примере CDC три представления: позицию журнала БД, offset записи Kafka и состояние строки в staging. Объясни, как snapshot, update и delete влияют на это состояние. Назови параметры, которых нет в показанном JSON, но без которых worker не заработает. Затем отдели проблему формата от отказа приёмника.