Работоспособность потока проверяется по продвижению чтения и записи результата. Ответ HTTP и живой контейнер ещё не показывают, что consumer loop продолжает работу. Для диагностики важно различать ошибки данных, временные отказы и недостаточный темп обработки; полезная проверка включает последовательность valid → poison → valid.
Ошибка данных и временный отказ требуют разных действий
Poison message — запись, которую обработчик не может применить без изменения данных или кода. Например, вместо целого размера в байтах пришла строка "unknown". Бесконечно повторять эту запись бессмысленно. Разрыв соединения с исправным приёмником — другая ситуация: повтор с задержкой может пройти.
Проверку данных ставят вокруг одной записи. Тогда плохая строка не выбросит из обработки следующие правильные. Перехватывают известные ошибки разбора или контракта. Ошибку памяти, недоступный диск или сбой записи результата нельзя автоматически объявить «плохими данными» и молча продолжить.
import json

def read_size(line):
    event = json.loads(line)
    if not isinstance(event, dict):
        raise ValueError("ожидается объект")
    size = event.get("size_bytes")
    if type(size) is not int or size < 0:
        raise ValueError("неверный размер")
    return size
Для трёх строк со значениями size_bytes: 100, "unknown", 200 правильная классификация сохраняет два размера и одну причину отклонения. Успехом всего шага можно считать результат по заранее выбранной политике: остановиться при ошибке либо сохранить её в карантин и продолжить. Без этой политики тихий пропуск даст красивый, но неполный отчёт.
DLQ сохраняет неприменённый факт для разбора
Dead Letter Queue, DLQ, в Kafka обычно является отдельным топиком карантина. Приложение сохраняет туда исходную запись или безопасную ссылку на неё, адрес (topic, partition, offset), причину, время и версию обработчика. Это позволяет исправить причину и организовать контролируемый повтор.
DLQ не возникает автоматически для каждого обычного consumer. Обработчик должен публиковать запись и проверить успех. В Kafka Connect есть настройки DLQ для поддержанных ошибок converter, transformations и sink processing; поддержка произвольного сбоя конкретного plugin определяется его реализацией.
Представь offsets 10, 11, 12 одной партиции. Результат 10 записан, ошибка 11 устойчиво сохранена в DLQ, результат 12 ещё ожидает запись. Следующая безопасная позиция по выбранной политике равна 12. Если публикация 11 в DLQ провалилась, продвинуть commit за неё нельзя: иначе после рестарта потеряем и факт, и причину.
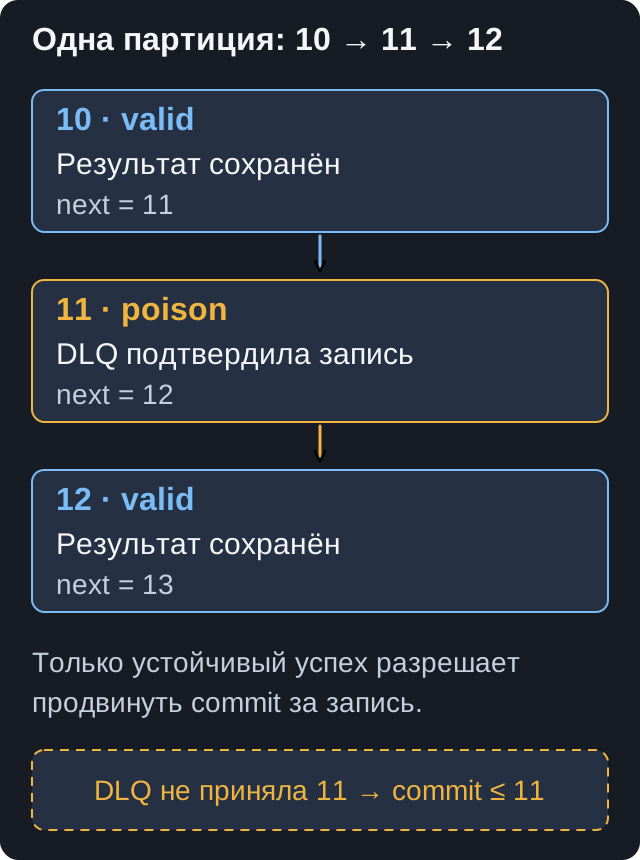
При независимых записи DLQ и commit тоже существует окно повторов. Карантин может получить повторную запись после сбоя; ключ по исходному адресу помогает его распознать. Kafka transaction способна атомарно связать публикацию в Kafka DLQ с входными offsets, если приложение правильно использует этот контур. Просто написать try/except для этого недостаточно.
У DLQ должен быть владелец, метрика количества отклонений и процедура возврата. Массовая ошибка схемы требует остановить проблемный выпуск, а не бесконечно складывать весь поток в карантин. Адреса и тела записей могут содержать чувствительные данные, поэтому доступ и формат диагностических сведений выбирают заранее.
Backpressure регулирует скорость поступления работы
Backpressure — управление темпом, чтобы следующий этап успевал обрабатывать вход. Consumer Kafka сам запрашивает данные, поэтому может уменьшить размер пачки, временно приостановить чтение отдельных партиций или ограничить число параллельных запросов к базе. При паузе нужно продолжать обслуживать клиентский цикл и участие в группе согласно API клиента.
Lag является симптомом отставания, а не самим механизмом backpressure. Если приходит 30 событий в секунду, а приёмник устойчиво принимает 20, backlog растёт на 10 в секунду. Буфер Kafka позволяет пережить временный дисбаланс, но при постоянном дисбалансе история достигнет границы хранения.
Пусть backlog равен 300, поступает 10 событий в секунду, а обрабатывается 25. Запас на догоняющую работу составляет 25 - 10 = 15, ориентир времени — 300 / 15 = 20 секунд. Если скорости равны, backlog не уменьшается. Если обработка медленнее входа, конечного времени догоняния при этих скоростях нет.
Большие пачки могут улучшить throughput приёмника, но увеличивают память и длительность одной обработки. Слишком много параллельных запросов перегружает базу и снижает throughput. Ограничение темпа, поиск узкого места и увеличение мощности — разные решения; выбор требует измерения.
Наблюдай путь данных целиком
Начни с четырёх уровней: публикация, брокеры, чтение, применение результата. У producer полезны ошибки и retries, размер пачек, скорость отправки и задержка. У брокеров — ISR, under-replicated и offline partitions, объём диска и ошибки запросов. У consumer — lag по партициям, active members, назначения, commits и частота rebalance. У приёмника — скорость успешной записи, ошибки и время последнего применённого события.
JMX-метрики Kafka можно собирать через exporter, хранить в Prometheus и показывать в Grafana. Эти инструменты не заменяют выбранные сигналы. Burrow и другие средства анализа lag помогают наблюдать группы, а бизнес-сверка отвечает, дошёл ли правильный факт до результата.
| Наблюдение | Следующая полезная проверка |
|---|---|
| Lag растёт только у одной партиции | Горячий ключ, объём и цена обработки этой партиции |
| Все партиции отстают, время записи выросло | Приёмник, его ошибки и предел параллельных запросов |
| Частые rebalance | Рестарты, связь и длительность обработки между poll |
| ISR сократился | Доступность followers и темп репликации |
| Диск быстро заполняется | Скорость входа, retention, реплики и свободный запас |
| HTTP жив, members нет и commit стоит | Работа consumer loop и его последняя ошибка |
Практика
Python работает с конечными учебными списками. Первая задача проверяет valid → poison → valid, вторая вычисляет checkpoint до первой незавершённой записи, третья оценивает догоняющий темп. У списка checkpoints специально непрерывные позиции, без compaction и транзакционных пропусков. В настоящем приложении следующую позицию берут из клиентского API.
После исправления consumer нужно проверить не только отсутствие исключения: последний valid должен попасть в результат, группа должна иметь active member, а commit и lag — показывать продвижение. В этих задачах сетевого consumer и DLQ нет; проверяется только обозначенная логика.
split_sizes(lines) принимает список JSON-строк. Верни пару (sizes, rejected): sizes — размеры корректных объектов с точным int size_bytes >= 0; rejected — индексы плохих строк с нуля. Неверный JSON, не-объект и неверный размер считаются плохой записью. Сохраняй порядок. Плохая строка не должна остановить следующие.
import json
| Ввод | Ваш вывод | Ожидаемый вывод | |
|---|---|---|---|
| ['{"size_bytes":100}', '{"size_bytes":"unknown"}', '{"size_bytes":200}'] | — | ([100, 200], [1]) | |
| ['broken', '{"size_bytes":0}', '{}'] | — | ([0], [0, 2]) | |
| [] | — | ([], []) | |
| скрытый тест 4 | |||