OLTP (Online Transaction Processing) и OLAP (Online Analytical Processing) называют типы задач, которые выполняют над данными. Это не названия СУБД и не синонимы строкового и колоночного хранения. Одна платформа может выполнять оба вида запросов, но требования к скорости, объёму чтения и обновлениям у них различаются.
Операционная система создаёт запись, меняет её статус или находит её по ключу. Аналитика читает много таких записей, чтобы сравнить периоды, группы и динамику показателя. Оба запроса могут быть написаны на SQL. Отличается работа, которую базе приходится выполнить.
OLTP: много коротких операций
Для OLTP типичны тысячи параллельных действий, затрагивающих немного строк. Пользователь не должен ждать секунды при открытии карточки. Обновление двух связанных таблиц должно либо завершиться целиком, либо откатиться. Здесь важны транзакции, ограничения целостности и предсказуемая задержка.
Например, перевод суммы между двумя счетами требует изменить оба остатка как одну транзакцию. Если второе изменение не удалось, первое не должно остаться применённым. Но OLTP не означает «только запись»: поиск конкретного объекта по ключу тоже обычная операция приложения.
OLAP: чтение многих строк ради вывода
Аналитический запрос может читать историю за год, выбирать несколько колонок, группировать по неделям и объединять справочники. Его результат — десятки строк, но чтобы их получить, движок обрабатывает миллионы исходных. Для OLAP важны пропускная способность чтения, объём памяти, способы агрегации и возможность запускать тяжёлые запросы, не мешая операционному сервису.
| Свойство | Типичная OLTP-нагрузка | Типичная OLAP-нагрузка |
|---|---|---|
| Единица работы | Одна операция над небольшим числом строк | Анализ большого диапазона данных |
| Изменения | Частые вставки и обновления | Загрузка партиями или потоком, редкие исправления подготовленных наборов |
| Время ответа | Часто миллисекунды для действия пользователя | От долей секунды до минут в зависимости от запроса |
| Форма данных | Удобна для корректной записи состояния | Удобна для чтения истории, фактов и измерений |
| Конкуренция | Много одновременных небольших операций | Меньше запросов, но каждый может читать значительно больше |
Это ориентиры, а не жёсткий разделитель. Бывают интерактивные аналитические запросы с очень коротким временем ответа и операционные пакетные операции. Поэтому при выборе платформы измеряют реальные запросы.
Почему «только SELECT» может мешать приложению
Запрос на чтение не меняет строки, но использует процессор для фильтрации, память для соединений и группировки, диск и сеть для получения данных. Если он сканирует миллионы строк, параллельным коротким операциям остаётся меньше ресурсов. В PostgreSQL механизм MVCC (многоверсионного управления конкурентным доступом) позволяет читателям и писателям во многих случаях не блокировать друг друга на уровне строк. Это снижает конфликты блокировок, но не создаёт дополнительные процессор и память. Кроме того, долго живущие снимки данных могут мешать своевременной очистке старых версий строк.
Читающая реплика принимает изменения от основной базы и позволяет выполнять отчёты на отдельном сервере. Это хороший первый шаг, если отчёты просты. Но реплика обычно отстаёт на некоторое время и повторяет структуру источника. Она не делает историю, общие ключи и витрины сама. Для этого нужен отдельный процесс подготовки данных.
Строковое и колоночное хранение
Теперь о физической организации. На схеме одни и те же три записи. В строковом варианте рядом лежат поля одного объекта. В колоночном — значения одного поля собраны вместе. Табличный результат для пользователя может выглядеть одинаково, но объём работы при чтении различается.
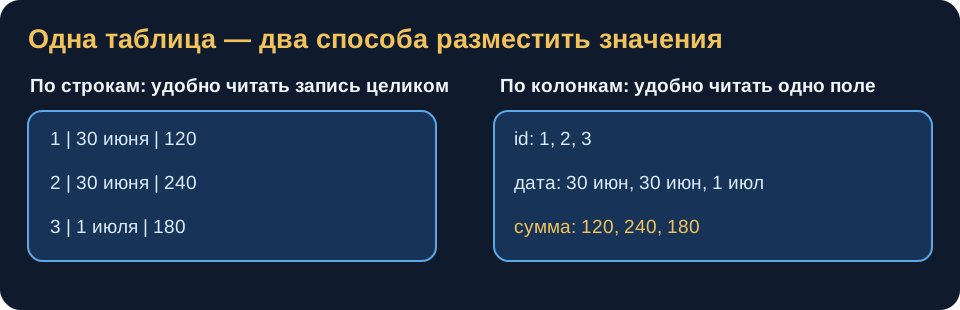
Если нужно получить все поля объекта с id = 2, строковое размещение удобно: нужные значения находятся рядом. Если нужно посчитать среднюю температуру за миллион наблюдений, колоночное размещение позволяет читать прежде всего столбец температуры, а не имена устройств и остальные поля каждой записи. Значения одного типа и похожего диапазона часто хорошо сжимаются вместе.
Но физическое размещение — лишь одна часть ответа. Индексы, партиции, формат файлов, кэш, параллелизм и способ выполнения запроса могут менять результат. PostgreSQL обычно хранит таблицы построчно и способен выполнять аналитику; ClickHouse использует колоночную организацию и может принимать частые вставки. Нельзя вывести тип нагрузки только по названию формата или продукта.
Большую таблицу иногда делят на партиции по дате, чтобы запрос читал только нужный период и чтобы было проще управлять хранением старых данных. Шардирование распределяет части таблицы между машинами ради ёмкости и вычислений. Это разные оси: таблица может быть разделена по месяцам и одновременно распределена по узлам. Физическую настройку партиций и распределения разберём в модулях конкретных движков; здесь важно понимать, почему аналитический запрос читает много данных.
Как это связано с DWH
DWH часто отделяют от операционной БД, чтобы длинные аналитические чтения не конкурировали с действиями пользователей и чтобы данные разных источников прошли согласование. Затем под характер аналитических запросов выбирают модель и систему хранения. На небольшом объёме отдельный кластер может быть лишним; на большом разница в организации данных и ресурсов становится существенной.
При проектировании полезно записать не «нам нужен OLAP», а конкретные ожидания: какие данные меняются, какие запросы читают большой диапазон, сколько пользователей работает одновременно, допустима ли задержка появления новых записей и за какое время нужен результат. Эти ответы помогают выбрать архитектуру намного точнее аббревиатур.
Попробуйте на данных
Для этой практики в учебной базе есть таблица orders: одна строка на заказ. Сравните две формы её чтения. WHERE order_id = 42 возвращает конкретную запись, а группировка по месяцу обрабатывает множество строк ради короткого результата:
SELECT order_id, status FROM orders WHERE order_id = 42;

SELECT date_trunc('month', created_at)::date AS month, count(*)
FROM orders
GROUP BY 1
ORDER BY 1;
В заданиях проверьте точечный поиск, месячную сводку и соединение с клиентами. Здесь важна форма работы, а не обещание, что один тип хранения всегда быстрее другого.
Получите order_id, status и total_amount для заказа 42. Это пример короткого чтения по ключу.