DWH (Data Warehouse, хранилище данных) — система, в которой данные из рабочих источников приводят к согласованному виду и сохраняют для анализа. Название не обозначает конкретную СУБД. DWH можно построить на PostgreSQL, ClickHouse, Greenplum или другой платформе; от выбора продукта не появятся общие определения показателей, связи источников и история изменений. Их нужно спроектировать и поддерживать.
Рабочие системы часто хранят разные части одного аналитического вопроса. В каждой могут быть свои ключи, часовые пояса и правила изменения записей. Соединить текущие таблицы по похожим полям недостаточно: такой запрос не объяснит, соответствуют ли ключи одному объекту и какое значение действовало на дату события. DWH сохраняет нужный вход и историю, задаёт правила сопоставления и делает расчёт воспроизводимым.
Источником может быть база приложения, поток событий, ответ API или файл партнёра. Задача хранилища возникает, когда для ответа нужно согласовать данные из этих источников и сохранить контекст, который нельзя получить из их текущего состояния.
Почему аналитика не должна зависеть от рабочей базы
Рабочая система рассчитана на действия пользователей: открыть карточку, изменить статус, списать остаток. Её база обязана быстро и надёжно обрабатывать множество небольших операций. Аналитический запрос нередко читает месяцы истории, соединяет большие таблицы и группирует миллионы строк. Он делит с приложением процессор, память, диск и пропускную способность. Даже запрос только на чтение может увеличить время отклика приложения.
Можно создать читающую реплику операционной БД. Она снимет часть нагрузки с основного сервера, но обычно повторит ту же структуру и текущее состояние. Реплика сама по себе не объединит разные источники, не объяснит показатель и не восстановит прошлые значения, если источник их не сохранял. Для простого отчёта по одной системе реплики может хватить; для согласованной истории — часто нет.
Отдельное хранилище также защищает аналитику от изменений приложения. Если разработчики переименовали поля или разделили одну таблицу на две, конвейер загрузки можно адаптировать на границе источника. Потребители подготовленных таблиц продолжают работать с прежним договорённым смыслом.
Что именно согласуют в DWH
| Вопрос | Пример решения | Что происходит без решения |
|---|---|---|
| Идентичность | Коды одного объекта из двух систем связывают по подтверждённому правилу | Одна сущность попадает в отчёт дважды |
| Единицы и типы | Вход в копейках приводят к рублям и явно указывают валюту | Суммы выглядят числовыми, но складываются неверно |
| Время | Различают дату события, изменения в источнике и загрузки | Опоздавшие записи попадают не в тот период |
| История | Для изменяемого признака сохраняют нужные версии | Старый отчёт незаметно меняется вслед за справочником |
| Показатель | Для доли завершённых операций задают условие и период | Два отдела публикуют разные «одинаковые» числа |
Хранилище не обязано вычислять все показатели заранее. Оно должно дать проверяемые данные и правила, по которым результат можно воспроизвести. Если показатель пересчитали из-за опоздавшего события, инженер должен знать, какая поставка и какое правило изменили ответ.
Согласование не означает, что нужно стереть различия между источниками. Два источника могут хранить разные значения одного признака, причём каждое верно для своего процесса. В ядре сохраняют происхождение обоих значений и отдельно задают правило выбора для конкретного расчёта. Тогда смена правила не превращается в ручную правку множества отчётов.
«Единый источник истины» означает согласованное определение опубликованного показателя и возможность проверить его происхождение. Это не обязательно одна физическая таблица со всеми данными компании. Для числа завершённых операций надо закрепить границы дня и часовой пояс, список завершающих статусов и правило для отменённых операций. Без этих деталей одинаковая формула COUNT(*) даст разные ответы.
Как данные проходят через хранилище
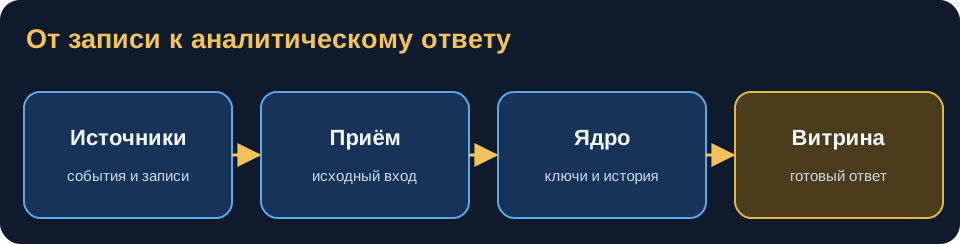
На входе полезно сохранить полученное от источника вместе с техническими метками: откуда пришла запись, когда получена и к какой поставке относится. Затем приводят типы и единицы, связывают объекты, выбирают актуальные версии и строят таблицы для анализа. Последний шаг — витрины: наборы с понятным зерном строки и показателями для группы задач. Между ними и графиком может быть семантический слой с общими определениями метрик.
Эти стадии иногда называют raw, staging, core, DDS, marts. Имена различаются между командами; важны границы ответственности. В следующей главе о слоях разберём их подробно. Не всякая архитектура содержит физическую базу для каждого слоя: это могут быть схемы одной СУБД, отдельные кластеры или файлы и таблицы поверх них.
От исходных данных до отчёта
На каждом переходе меняется не только форма данных, но и ответственность за их смысл.
| Шаг | Что появляется | Зачем это нужно |
|---|---|---|
| Получение | Исходные данные с источником, временем и идентификатором поставки | Повторить загрузку и проверить её вход |
| Сопоставление | Подтверждённое соответствие идентификаторов разных систем | Объединять сведения об одном объекте без случайных совпадений |
| История | Версии атрибутов и границы их действия | Восстанавливать состояние на дату события |
| Витрина | Набор с заданным зерном, связями и определением показателей | Получать отчёт без повторного ручного согласования источников |
Исправление прошлых данных может потребовать пересчёта зависимых витрин. Успешная запись в ядро ещё не подтверждает, что опубликованный показатель обновлён. Конвейер должен знать зависимости и отмечать, какая поставка использована в каждом результате.
На границах проверяют полноту входа, долю несопоставленных ключей и кратность соединений. Если после JOIN одна исходная запись превратилась в несколько, итоговая сумма может вырасти без появления новых событий. Такие проверки позволяют отличить отсутствие событий от потери данных при загрузке.
DWH, СУБД, витрина и BI — разные уровни
СУБД хранит данные и выполняет запросы. PostgreSQL может быть рабочей базой или основой небольшого DWH. ClickHouse часто используют для аналитических таблиц. По одному названию продукта нельзя понять, согласованы ли в нём источники.
DWH — архитектура и набор процессов: получение, проверка, согласование и предоставление данных для аналитики. Физически она опирается на СУБД и другие компоненты.
Витрина данных (data mart) — подготовленная часть данных под конкретный круг вопросов. Например, таблица с одной строкой на день и тип события помогает строить дневной отчёт. Она может быть внутри DWH или предоставляться отдельной системой. Витрина не равна всему хранилищу: в ней обычно меньше деталей и уже закреплены правила расчёта.
BI-инструмент показывает таблицы и графики. Он может вычислять метрики, но красивый дашборд не исправит пропущенные записи, неверную историю или несогласованный ключ. Смысл результата начинается до визуализации.
История и исправления
Хранилище часто нужно именно потому, что текущего состояния мало. Если признак объекта изменился, прошлый отчёт можно пересчитать по нынешнему значению либо оставить классификацию, действовавшую тогда. Это два разных вопроса. Для второго надо сохранить границы действия прежней версии. Если старое значение перезаписано в источнике до загрузки, восстановить его из текущей строки нельзя.
История бывает разной. Факт события обычно привязан к времени самого события. История описания объекта хранит версии атрибутов с интервалами действия. История поставок показывает, что система знала на момент загрузки. Иногда нужны все три даты; иногда достаточно одной. Выбор зависит от вопросов и стоимости хранения, а не от лозунга «хранить всё навсегда».
В DWH возможны обновления и исправления. Утверждение «хранилище неизменно» следует понимать как запрет бесконтрольной правки опубликованных чисел. Опоздавшие события, удаление по требованиям и исправления источника реальны. Для них задают правила пересчёта, проверки и публикации новой версии.
Время события и время, когда о нём узнало хранилище, тоже отвечают на разные вопросы. Если обращение от 12 апреля пришло 14-го, отчёт «сколько обращений было 12-го» обычно должен учитывать его после пересчёта. А отчёт «какие данные были доступны утром 13-го» не должен задним числом делать вид, что запись уже существовала. Поэтому вместе с предметной датой полезно хранить метку загрузки и идентификатор поставки.
Какие решения принимают до выбора СУБД
Первый вопрос — что означает строка каждого набора. В таблице отдельных событий одна строка соответствует одному событию; в дневной витрине — сочетанию дня и выбранных разрезов. Если смешать эти уровни без явного правила, JOIN может размножить события, а сумма или количество вырастут. Это свойство называют зерном таблицы. Его фиксируют до написания итогового запроса.
Затем договариваются о времени и задержке. Отчёт за вчера можно обновлять один раз ночью, а операционному экрану может требоваться новое состояние через минуты. Более частая загрузка добавляет стоимость и усложняет исправление опоздавших данных. Требование «всё в реальном времени» само по себе не указывает, какая свежесть действительно нужна конкретному пользователю.
| Решение | Вопрос, на который нужно ответить |
|---|---|
| Зерно | Что представляет одна строка и можно ли её соединить с другой таблицей без размножения? |
| История | Нужно ли видеть состояние на дату события или достаточно текущего значения? |
| Свежесть | Сколько времени может пройти от изменения источника до появления в отчёте? |
| Исправления | Как повторно обработать поставку и какие витрины пересчитать после ошибки? |
| Качество | При каких потерях, дублях или несопоставленных ключах публикацию надо остановить? |
Эти ответы составляют контракт данных для читателя и загрузчика. Он может быть оформлен в документации и проверках конвейера, а не обязательно в отдельном продукте. Если отчёт внезапно изменился, по контракту можно выяснить, было ли это ожидаемое исправление истории, новая поставка или ошибка обработки.
Когда отдельный DWH может подождать
Если данных мало, источник один и отчёты не мешают приложению, достаточно аналитических таблиц в существующей инфраструктуре. Сначала зафиксируйте определения показателей, периодов и ключей, затем измерьте нагрузку. Выделять отдельный кластер имеет смысл, когда появляются конкурирующие запросы, несколько источников, требования к истории и повторяемости расчётов.
Главный вопрос на проектировании: сможет ли другой человек объяснить, из каких исходных записей и по какому правилу получено число в отчёте? Если нет, проблема не решается переносом тех же таблиц на более мощный сервер.
Попробуйте на данных
В песочнице есть текущая таблица orders и версии признаков клиента в customers_history. В истории customer_id связывает версию с клиентом, segment хранит его признак, а valid_from и valid_to задают интервал действия: начало включено, конец нет. Когда соединяете заказ с версией, сравнивайте дату заказа с этим интервалом. Если связанного клиента нет, LEFT JOIN сохранит заказ, а поля правой таблицы станут NULL — так можно посчитать потери связи.
Например, этот запрос показывает, сколько заказов относится к каждому статусу в июне:
SELECT status, count(*) AS orders_count
FROM orders
WHERE created_at >= '2026-06-01' AND created_at < '2026-07-01'
GROUP BY status
ORDER BY status;
Это ответ по одному источнику и текущему состоянию заказов. Для исторического разреза придётся подобрать версию клиента на дату события; для контроля результата — проверить несвязанные ключи. Все три шага можно выполнить ниже.
Посчитайте число заказов по месяцам с января по июнь 2026. Верните month (date) и order_count по возрастанию месяца.