Загрузка, которая на тестовом файле работала секунду, на боевом падает с MemoryError или просто убивается в контейнере по лимиту памяти. Чтобы такого не было, нужно понимать не синтаксис, а механику: что именно лежит в памяти в каждый момент и кто это держит. В прошлом уроке была модель «объект и ссылки». Здесь она становится количественной: у каждого объекта есть счётчик ссылок, и память освобождается ровно тогда, когда он доходит до нуля.
Объект считает ссылки на себя
Каждый объект в CPython хранит в заголовке два поля: счётчик ссылок и указатель на тип. Счётчик увеличивается, когда на объект появляется новая ссылка: имя, место в списке, ключ или значение словаря, атрибут другого объекта, аргумент функции. Уменьшается, когда ссылка исчезает. Как только счётчик стал нулём, объект уничтожается сразу, в этой же строке кода, без участия сборщика мусора.
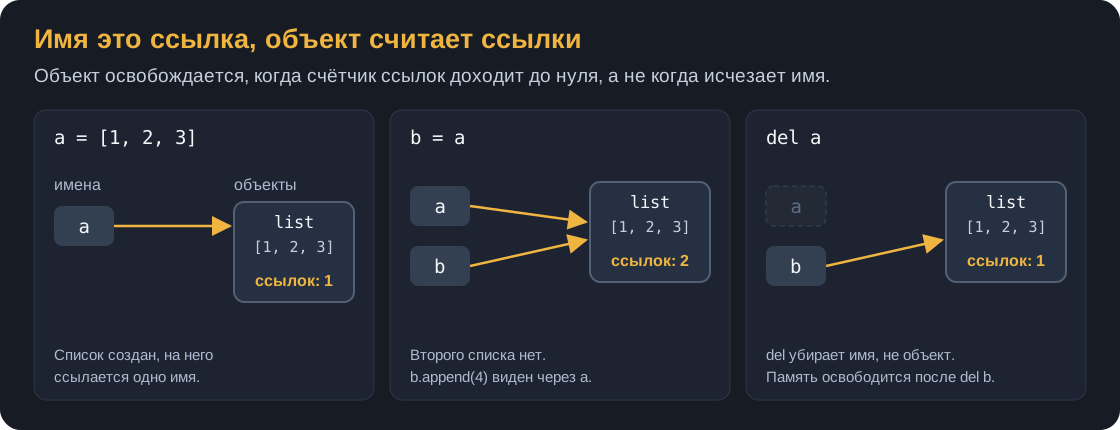
del a не удаляет список, а убирает имя. Это важно для интуиции: написать del big_list в середине функции бесполезно, если тот же список ещё лежит в словаре или его держит другой объект.
Счётчик можно посмотреть, но с оговоркой:
import sys

rows = [{"id": 1}]
print(sys.getrefcount(rows))   # 2: имя rows и аргумент getrefcount
Сам вызов добавляет временную ссылку, поэтому число на единицу больше, чем «настоящее». Для маленьких целых и односимвольных строк getrefcount показывает огромные значения: такие объекты общие для всего интерпретатора, а начиная с Python 3.12 часть из них «бессмертна» и счётчик для них вообще не меняется.
Что происходит на каждой итерации цикла
Разница между «файл обработался» и «скрипт упал по памяти» обычно решается тем, кто держит прочитанные строки. Сравните два цикла, которые делают одно и то же.
Первый читает всё в список и идёт по нему:
rows = read_all(path)          # список словарей, по одному на строку файла
for row in rows:
    process(row)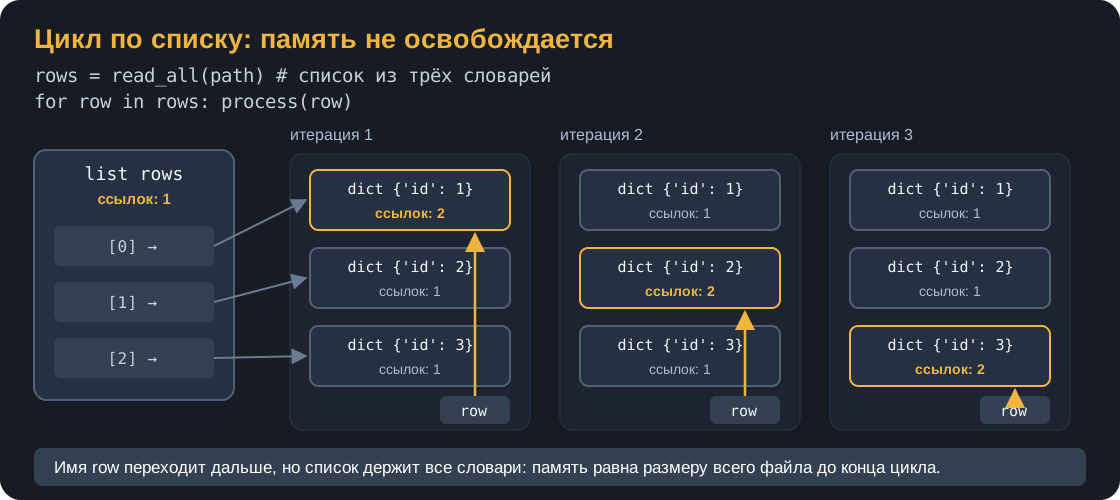
На каждой итерации имя row перепривязывается к следующему словарю. Счётчик предыдущего уменьшается на единицу, но не до нуля: список rows по-прежнему ссылается на него. Поэтому до конца цикла в памяти лежит весь файл, а пик памяти равен размеру всех словарей сразу. Для файла в 20 млн строк это десятки гигабайт, потому что каждый словарь с тремя полями занимает несколько сотен байт.
Второй цикл читает файл построчно:
with open(path, encoding="utf-8") as f:
    for line in f:
        process(line)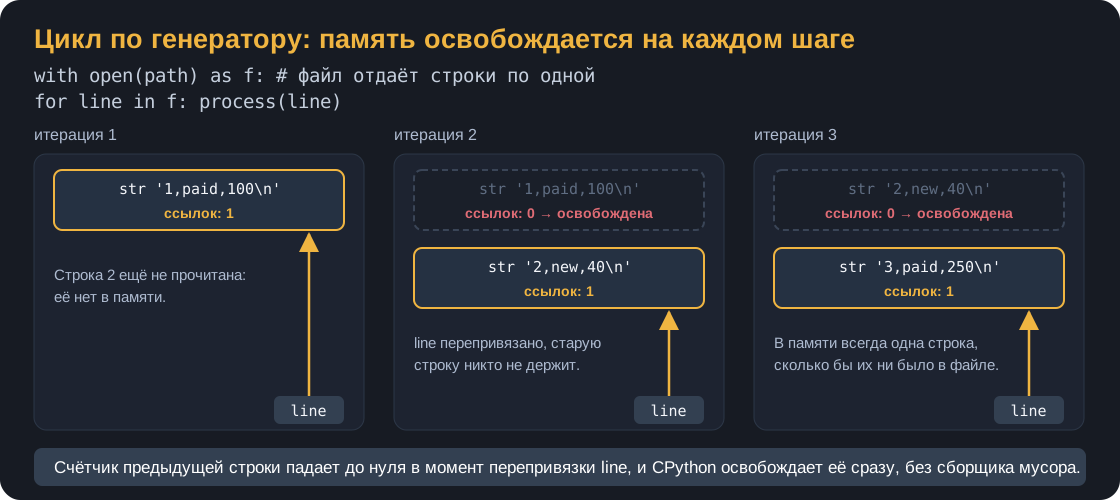
Файловый объект это итератор: он отдаёт строку только когда её попросили, и сам её не хранит. После process(line) интерпретатор перепривязывает line к следующей строке, счётчик старой падает до нуля, и она освобождается прямо сейчас. Пик памяти равен одной строке плюс то, что оставил process. Размер файла на это не влияет.
Отсюда главное правило обработки данных в Python: не копить, а протаскивать. Список нужен, когда данные требуются целиком (сортировка, поиск дублей по всему файлу). Для «прочитать, преобразовать, записать» список не нужен, и всё, что вы в нём накопите, будет жить до конца функции.
Та же механика объясняет популярную ошибку с накоплением:
result = []
for line in f:
    result.append(transform(line))   # все преобразованные строки живут в result
write_all(result)
Строки line освобождаются, а объекты, которые вернул transform, нет: их держит result. Если write_all умеет принимать итератор, список лишний:
write_all(transform(line) for line in f)Так на каждом шаге в памяти одна исходная строка и одна преобразованная. В уроке про генераторы этот приём разобран подробнее.
Кадр функции
Локальные имена функции живут в её кадре. Кадр создаётся при вызове и уничтожается при return, вместе с ним исчезают все локальные ссылки.
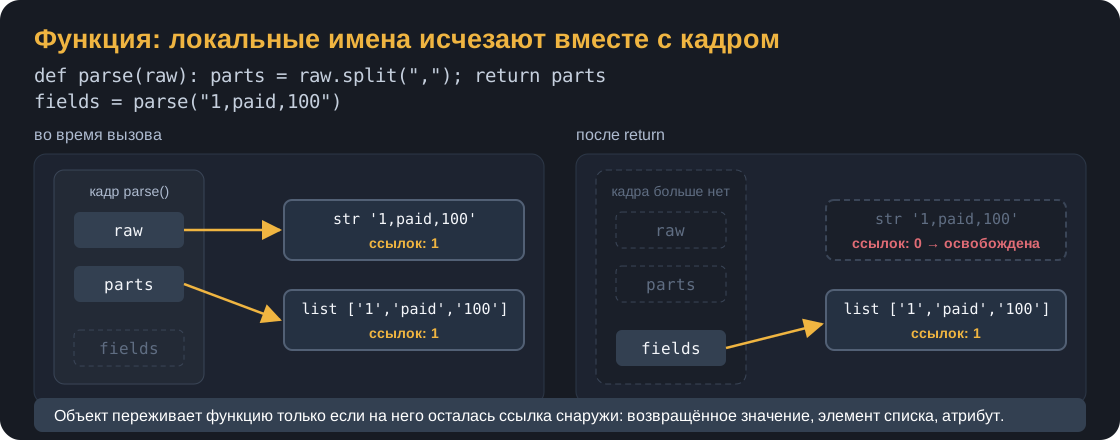
Объект переживает функцию, только если на него осталась ссылка снаружи: возвращённое значение, которое вызывающий код куда-то привязал, элемент внешнего списка, атрибут. Это ответ на вопрос «зачем выносить обработку в функцию, если я и так всё делаю в цикле»: всё временное, что функция создала по дороге, гарантированно освобождается на выходе. В длинном скрипте без функций временные списки живут до конца модуля.
Обратная сторона: функция, которая принимает большой список и возвращает его «очищенную» копию, удваивает пик памяти на время своего выполнения. Оба списка живы одновременно: исходный держит вызывающий код, копию держит кадр.
Циклы ссылок и сборщик мусора
Счётчик ссылок не справляется с одним случаем: объекты, которые ссылаются друг на друга.
table.rows = [row]
row.table = table
del table, row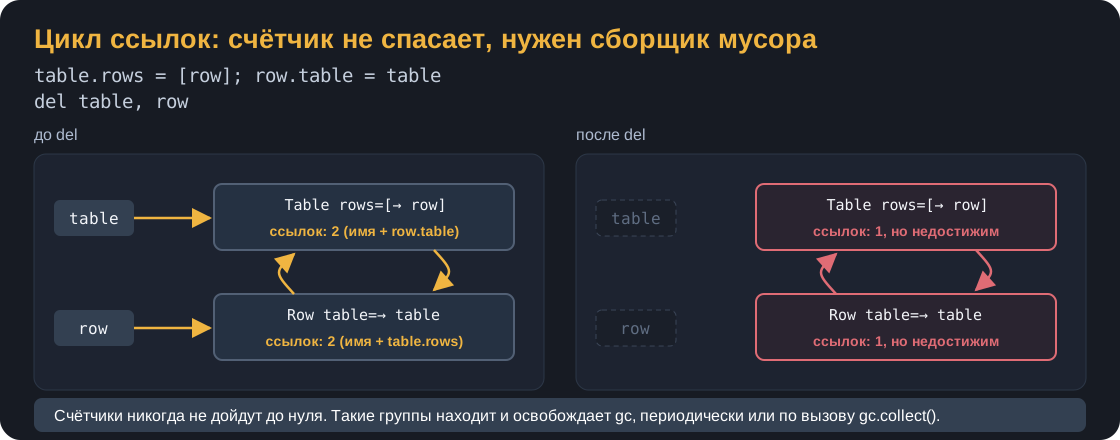
После del имён нет, добраться до объектов из программы нельзя, но у каждого счётчик равен единице: сосед его держит. Такие группы освобождает второй механизм, сборщик мусора (gc). Он периодически обходит объекты-контейнеры, находит циклы, до которых нет пути снаружи, и уничтожает их. Запускается он по счётчику выделенных объектов, в три поколения: молодые объекты проверяются часто, старые редко. Вызвать его вручную можно через gc.collect(), но в рабочем коде это почти всегда признак того, что проблему нужно решать иначе.
Циклы в коде инженера данных встречаются чаще, чем кажется: запись знает свою таблицу, таблица хранит записи; узел дерева знает родителя; объект хранит замыкание, которое ссылается на него же. Пока таких объектов тысячи, разницы нет. Когда их миллионы, память освобождается рывками и позже, чем вы ожидаете. Способ не создавать цикл: ссылка в одну сторону, а обратная через weakref, или явный метод close(), который разрывает ссылки.
Почему память не вернулась системе
Частый вопрос после загрузки: список удалён, gc.collect() вызван, а процесс в мониторинге по-прежнему занимает 6 ГБ. Это нормально. Для маленьких объектов CPython использует собственный аллокатор pymalloc, который берёт у системы память большими блоками (аренами по 1 МБ) и нарезает их на объекты. Арена возвращается системе, только когда в ней не осталось ни одного живого объекта. Достаточно одного маленького долгоживущего объекта в арене, чтобы весь мегабайт остался за процессом.
Поэтому память скрипта измеряют не по графику в мониторинге, а по тому, что реально живо. Для этого есть tracemalloc:
import tracemalloc

tracemalloc.start()
rows = load(path)
current, peak = tracemalloc.get_traced_memory()
print(f"сейчас {current / 2**20:.1f} МБ, пик {peak / 2**20:.1f} МБ")
Пик обычно интереснее текущего значения: именно он определяет, пройдёт ли задача в контейнере с лимитом.
Как это влияет на код загрузки
Несколько следствий, которые имеет смысл помнить при написании любого скрипта с данными.
Каждый объект стоит дорого. Словарь с тремя полями занимает около 200 байт, список из миллиона чисел 8 МБ ссылок плюс 28 МБ самих чисел. Миллион строк в виде списка словарей это гигабайты. Если данные табличные и их много, их место в pandas, pyarrow или в базе, где колонка чисел лежит плотно и без заголовков объектов.
Если объекты одного класса создаются миллионами, __slots__ убирает у каждого словарь атрибутов и экономит в два-три раза. dataclass(slots=True) делает то же самое одной строкой.
Пик памяти определяется самым большим одновременно живым набором объектов, а не суммой всего, что было создано. Поэтому обработка чанками (прочитать 100 тысяч строк, обработать, записать, забыть) держит память постоянной при любом размере входа.
Глобальные имена живут до конца программы. Большой объект, привязанный к имени на уровне модуля, не освободится никогда, даже если нужен был только в начале.
Как отвечать на собеседовании
Как работает память в Python? Все объекты живут в куче, имена и контейнеры хранят ссылки. Для маленьких объектов CPython использует свой аллокатор pymalloc с аренами, поэтому освобождённая память может не вернуться операционной системе. Локальные имена живут в кадре функции и исчезают при return.
Как работает сборщик мусора? Основной механизм это счётчик ссылок: объект уничтожается сразу, когда счётчик стал нулём. Циклы ссылок счётчик не ловит, их находит сборщик gc, который периодически обходит объекты-контейнеры по трём поколениям и освобождает недостижимые циклы. Запускается автоматически по порогам выделений, вручную через gc.collect().
Как очищается память на каждой итерации цикла? Имя цикла перепривязывается к следующему элементу, счётчик предыдущего уменьшается. Если элементы отдаёт итератор (файл, генератор), предыдущий элемент освобождается сразу. Если цикл идёт по списку, список держит все элементы, и память не освобождается до конца.
Почему del не освобождает память? del удаляет имя, а не объект. Объект живёт, пока есть хоть одна ссылка: другой список, словарь, атрибут, кадр функции.
Практика
Функция sum_file(path) возвращает сумму целых чисел из файла, по одному числу в строке. Пустые строки пропускаются. Файл может быть больше памяти, поэтому читать его целиком нельзя: ни read(), ни readlines(), ни splitlines(). Пройдите по файлу построчно.
Заготовка читает весь файл в список и решает задачу, но проверка способа её не засчитывает.
| Ввод | Ваш вывод | Ожидаемый вывод | |
|---|---|---|---|
| "numbers.txt" | — | 60 | |
| "one.txt" | — | 5 | |
| "empty.txt" | — | 0 |