Нормализация нужна, когда разные сведения оказались в одной таблице и начинают мешать друг другу. Допустим, платформа хранит курсы, их учебные блоки и преподавателей в одной выгрузке. Пока строк мало, таблица кажется удобной. Затем появляется блок с таким же названием в другом курсе, а позже один блок ведут два преподавателя. Каждая новая строка заставляет пересматривать прежние предположения.
Сначала разберёмся, что означает строка и какие правила действительно действуют. Нормальная форма не выбирается по внешнему виду таблицы: она следует из зависимостей между её атрибутами.
Исходная таблица и первые аномалии
Представим широкую таблицу:
| Курс | Описание курса | Блок | Номер | Преподаватель | Биография |
|---|---|---|---|---|---|
| Data Engineer | Инженерные основы | SQL | 1 | Ирина | Работает с БД |
| Data Engineer | Инженерные основы | Визуализация | 2 | Олег | Разрабатывает BI |
| Pre Data Engineer | Старт в профессии | SQL | 1 | Ирина | Работает с БД |
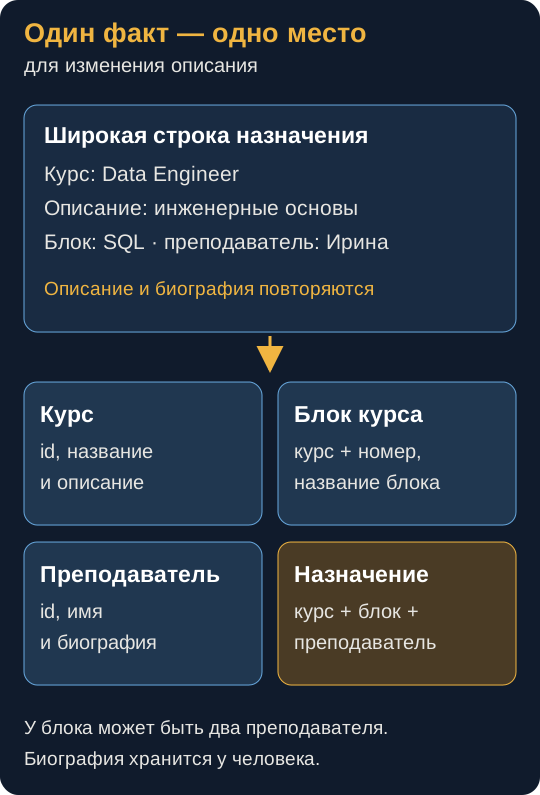
Описание курса повторяется для каждого блока; биография Ирины — для каждого её назначения. Если изменить описание Data Engineer в одной строке, а во второй забыть, появятся два «текущих» описания одного курса. Если курс ещё не имеет блоков, его некуда добавить без пустой строки преподавателя. Если удалить последнюю строку курса, вместе с назначением преподавателя исчезнет описание курса. Это аномалии обновления, вставки и удаления.
В реляционной модели строка выражает утверждение с определёнными атрибутами. В SQL-таблице ключи и ограничения задают явно; порядок вывода задаёт ORDER BY запроса.
Кандидатный ключ
Кандидатный ключ — минимальный набор атрибутов, который однозначно определяет строку во всех допустимых состояниях данных. Уникальность означает, что две разные строки не могут иметь один ключ; минимальность — что ни один атрибут нельзя убрать без потери этого свойства. Один из кандидатных ключей выбирают первичным. Добавить искусственный id можно, но он не отменяет предметного правила уникальности.
В первом снимке таблицы название блока «Визуализация» встречается один раз. Можно ошибочно объявить название блока ключом. На следующей неделе тот же блок появляется в курсе Pre Data Engineer. Теперь одного названия недостаточно: в этой модели блок можно идентифицировать парой (курс, номер блока) или подтверждённой парой (курс, название блока), если внутри курса названия действительно уникальны.
Потом выясняется, что блок ETL ведут два преподавателя. В широкой таблице назначений пара (курс, блок) уже повторяется; для строки назначения нужен ещё преподаватель. Но это не значит, что сущность «блок курса» потеряла свой ключ. Блок остаётся одним, а назначений преподавателей у него несколько. Смешение двух уровней данных как раз и создавало проблему.
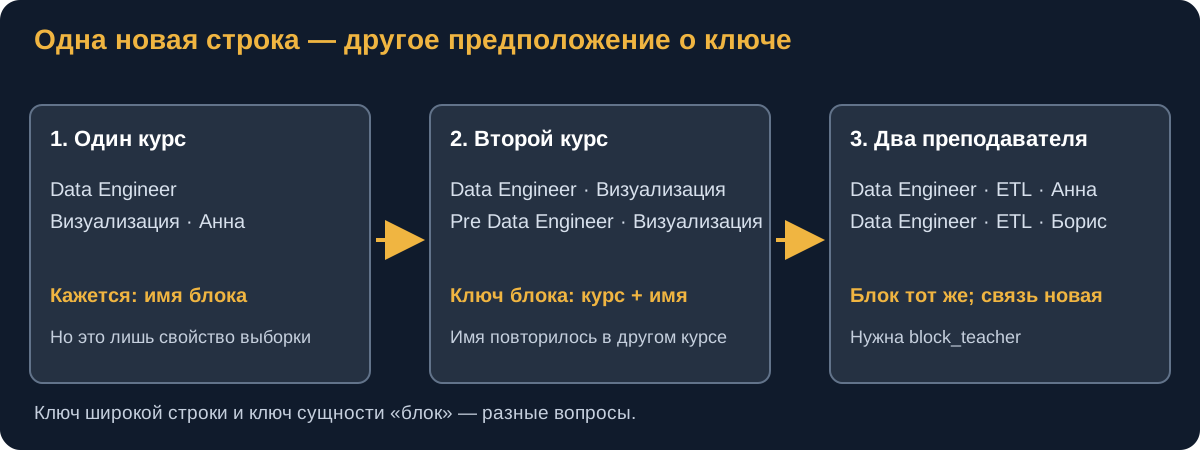
На практике имена могут меняться. Поэтому курс и преподавателя часто идентифицируют стабильными кодами, а блок — номером или отдельным id внутри курса. Бизнес-ключ и технический ключ могут сосуществовать: первый фиксирует правило предметной области, второй удобен для ссылок.
Функциональная зависимость
Запись X → Y означает: если две допустимые строки имеют одинаковое X, они обязаны иметь одинаковое Y. Например, если course_id однозначно обозначает курс, то course_id → course_title, course_description. Если teacher_id однозначно обозначает преподавателя, то teacher_id → teacher_name, teacher_bio.
В нашей модели есть ещё зависимость (course_id, block_no) → block_title: номер блока имеет смысл в пределах курса. В таблице назначений тройка (course_id, block_no, teacher_id) определяет конкретное назначение. Правила берутся из предметной области, а не из того, что случайно совпало в трёх учебных строках. Две одинаковые биографии не делают преподавателей одним человеком.
Суперключ определяет все атрибуты строки, но может содержать лишние поля. Кандидатный ключ — минимальный суперключ. Например, к тройке назначения можно дописать название курса; уникальность сохранится, но название будет лишним и не сделает набор кандидатным ключом.
Первая нормальная форма: одно значение на место
В курсе может быть три преподавателя. Если записать их в одном поле строкой «Ирина, Олег, Мария», поиск назначений и проверка уникальности потребуют разбора текста. Для данной модели лучше отдельные строки связи между блоком и преподавателем. Так каждое назначение можно добавить, удалить и связать с датой или ролью независимо.
1НФ требует одного значения заданного домена в каждой позиции строки. Для назначений преподавателей это означает отдельные строки связи вместо списка имён. JSON может хранить исходный документ целиком; его элементы выделяют в отношения, когда ими нужно независимо управлять в реляционной модели.
Номер блока и его название тоже лучше разделить. Строка «2. Визуализация» заставит разбирать префикс всякий раз, когда понадобится сортировка блоков по номеру. Номер — отдельный атрибут, название — отдельный.
Вторая нормальная форма: зависимость от полного ключа
Предположим, широкая таблица теперь имеет строку на одно назначение преподавателя блоку. Кандидатный ключ при наших правилах — (course_id, block_no, teacher_id). Описание курса зависит только от course_id; название блока — от (course_id, block_no); биография преподавателя — от teacher_id. Все это частичные зависимости от собственного поднабора составного ключа.
2НФ требует 1НФ и отсутствия такой зависимости у неключевых атрибутов от части любого кандидатного ключа. Если оставить широкую таблицу, одно изменение описания курса придётся проводить во всех назначениях. Разделение следует прямо из зависимостей:
course(course_id, course_title, course_description)
block(course_id, block_no, block_title)
teacher(teacher_id, teacher_name, teacher_bio)
block_teacher(course_id, block_no, teacher_id)
У block ключ (course_id, block_no). У block_teacher — тройка; внешние ключи ссылаются на block и teacher. Курс можно создать до первого блока, блок — до назначения преподавателя, а второго преподавателя можно назначить без копирования описания курса.
Первичный ключ block_teacher запрещает повторить ту же тройку, но позволяет двум преподавателям вести один блок. Составной внешний ключ (course_id, block_no) проверяет существование именно этого блока курса.
Если добавить каждой строке исходной широкой таблицы surrogate id, частичные предметные зависимости никуда не исчезнут. Формальная проверка 2НФ требует рассмотреть все кандидатные ключи и допустимые зависимости, а не остановиться на PRIMARY KEY(id).
Третья нормальная форма: убрать зависимость через другое описание
Представим, что в строку блока добавили имя и биографию ведущего преподавателя. Если teacher_id определяет биографию, а ключ блока определяет teacher_id, биография зависит от ключа блока через преподавателя. Повтор в каждом блоке снова создаёт аномалию: исправленная биография может сохраниться не везде.
3НФ в обычном объяснении требует, чтобы неключевое описание не зависело от ключа через другое неключевое описание. В нашей схеме teacher хранит сведения о преподавателе, а block_teacher — связь преподавателя с блоком. Если у курса есть отдельный хедлайнер, course хранит его идентификатор, а биография остаётся в teacher. Связь «хедлайнер курса» и связь «ведёт блок» не одно и то же.
Проверить разложение обратным соединением
Разбить таблицу мало. После JOIN новых отношений должны получаться только исходно допустимые сочетания. Если хранить отдельно (курс, блок) и (курс, преподаватель), а потом соединять их по курсу, получится, будто каждый преподаватель ведёт каждый блок. Пары сами по себе не сохраняют сведения о назначении конкретному блоку. Поэтому отдельная таблица block_teacher обязательна, пока это реальный факт предметной области.
| Курс | Блок | Преподаватель |
|---|---|---|
| DE | SQL | Ирина |
| DE | ETL | Олег |
Проекции (курс, блок) и (курс, преподаватель) после JOIN дадут четыре строки, в том числе несуществующие «SQL — Олег» и «ETL — Ирина». Значения не потеряны по отдельности, но потеряна связь между ними. Такое разложение называют соединением с потерями.
Для регулярного отчёта позже можно собрать более широкую аналитическую таблицу или измерение звезды. Это осознанный производный слой: описания повторяются ради удобного чтения, а управляемое место изменения исходных правил остаётся понятным. Нормализация отвечает за согласованное хранение зависимостей; витрина — за удобный путь к конкретному вопросу.