Поток данных может продолжаться без заранее известного конца. Новые записи появляются постоянно, а нескольким приложениям нужно читать их с разной скоростью. Потоковая обработка позволяет работать с поступлениями по мере появления. Kafka хранит общий журнал, отделяя отправку записей от их чтения и повторной обработки.
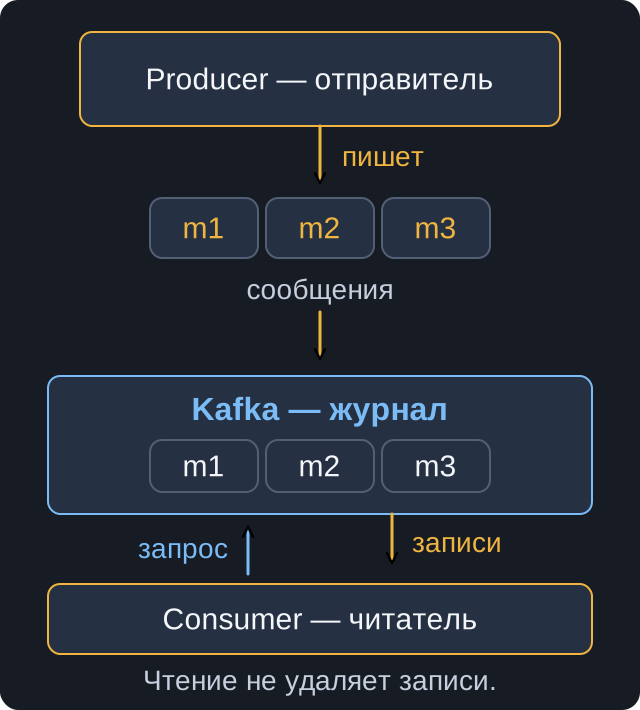
Приложение producer отправляет сообщения в Kafka. Приложение consumer запрашивает записи из журнала и обрабатывает их. Сообщения остаются в Kafka после чтения: consumer продвигает свою позицию, а не забирает запись навсегда.
Событие сообщает о факте
Событие фиксирует произошедший факт. Команда выражает просьбу выполнить действие. Например, create_file просит создать файл, а file_created сообщает, что создание завершилось. Получатели события самостоятельно решают, как использовать этот факт; отправитель не перечисляет в нём все будущие реакции.
Таблица текущего состояния показывает результат последних изменений. Журнал событий сохраняет сами изменения и их порядок. Из доступной истории можно восстановить состояние на выбранный момент, измерить интервалы или пересчитать результат другим алгоритмом.
{
  "event_id": "e-1",
  "event_type": "file_created",
  "occurred_at": "2026-10-01T12:03:00Z",
  "path": "sample.txt"
}
event_id отличает факт от его повторной доставки. event_type задаёт тип факта, occurred_at — время его возникновения, path — данные этого небольшого примера. Автор и читатели потока должны согласовать поля и их смысл. Корректный JSON ещё не означает соблюдение такого контракта.
Поток продолжается, а обработка успевает за ним
Event streaming объединяет непрерывное получение событий, их хранение и обработку. Источник добавляет новые записи, потребитель читает доступные записи и затем ждёт следующие. У потока обычно нет заранее известного конца.
Батч работает с ограниченным набором: например, всеми записями за завершённые сутки. Поток обрабатывает новые поступления по мере появления. При этом внутри streaming-приложения допустимы небольшие пачки. Разница определяется способом работы с продолжающимися данными и требуемой задержкой, а не наличием цикла вместо SQL.
Если результат нужен раз в сутки, ежедневный батч может быть проще. Если изменение должно стать доступным приложениям за несколько секунд, часовой интервал обновления слишком велик. Ускорение добавляет обязанности: переживать повторы, восстанавливать позицию, контролировать отставание и сохранять совместимость событий.
Kafka хранит журнал для независимых читателей
Apache Kafka является распределённой платформой потоков событий. Сервер broker хранит записи и отвечает на запросы приложений. Логический поток называется topic, или топик. На следующем шаге разберём его разделение на партиции.
Ключевое свойство журнала: чтение одним приложением не стирает запись для другого. Витрина уже прочитала события e-101, e-102, e-103, а сервис уведомлений дошёл только до e-101. Оба используют один поток, но имеют собственные позиции. Источник не вызывает каждый сервис по очереди и не ждёт выполнения всех реакций.
Так устроена event-driven architecture: участники реагируют на события. Kafka может служить общей шиной, но архитектуру определяют контракты и поведение приложений. Например, новое уведомление можно добавить отдельным потребителем, не меняя расчёт витрины. Цена независимости: изменения становятся видны в разных местах в разное время. Приложения должны явно показывать статус обработки и уметь восстанавливаться.
Журнал позволяет replay, повторное чтение сохранённой истории. После исправления расчёта отдельный читатель может пересчитать витрину. История доступна в пределах политики хранения: Kafka не превращает любой топик в вечный архив. Повторный запуск также требует безопасного приёмника, чтобы повторное чтение не умножило уже применённый эффект.
Журнал и очередь решают разные задачи
В обычной рабочей очереди сообщение передают одному исполнителю, а после подтверждения обработки удаляют. Это удобно для задания «сформируй один PDF». При неуспешной обработке возможна повторная доставка другому исполнителю. У Kafka событие остаётся в журнале после чтения; продвижение читателя сохраняется отдельно.
| Требование | Что подходит по модели |
|---|---|
| Несколько независимых отчётов по одной истории | Журнал с отдельными позициями читателей |
| Раздать задания свободным исполнителям | Рабочая очередь с подтверждениями |
| Пересчитать результат за вчера | Сохранённый журнал и управляемый replay |
| Маршрутизировать задания по правилам получателей | Exchanges и bindings обычной модели RabbitMQ |
RabbitMQ поддерживает обычные очереди, реплицируемые quorum queues и отдельную модель Streams с хранением и повторным чтением. Kafka тоже подходит для асинхронного обмена между сервисами. Поэтому выбор нельзя свести к «Kafka быстрая, RabbitMQ медленная». Сначала опиши хранение, подтверждения, маршрутизацию, параллелизм и восстановление; затем сравни конкретные режимы и измерь нагрузку.
Как работать с модулем
Нужны основы SQL, функции и коллекции Python. Docker понадобится в отдельной локальной практике. Сначала изучи журнал, producer и позиции чтения, затем проверь их на визуализации. После этого переходи к группам, отказам, доставке, хранению и интеграциям. Завершим модуль обзором обработки потоков в Spark и Flink: их ролью рядом с Kafka, окнами и состоянием вычисления.
Встроенные SQL и Python анализируют небольшие синтетические данные. Они помогают проверить расчёт или функцию и не подключаются к брокеру. Настоящий Kafka CLI будем запускать отдельно на твоём компьютере.
Самопроверка
Перед проверкой объясни своими словами: почему витрина и уведомления читают один факт независимо; что сохранится после чтения; какой риск возникает при повторном применении событий. В тесте выбери подходящую модель и разбери объяснения остальных вариантов.