Репликация хранит копии партиции на нескольких брокерах, чтобы отказ одного узла не уничтожил единственный журнал. Устойчивость зависит и от числа назначенных копий, и от их фактического состояния. Подтверждение producer, синхронизация реплик и доступность записи для чтения имеют разные границы.
Одна партиция имеет несколько реплик
Replication factor, RF, задаёт количество копий каждой партиции, включая лидера. RF=3 означает одну лидирующую и две остальные реплики. Это не три независимые партиции и не три дополнительных читателя одной группы.
Leader организует добавление записей и задаёт порядок журнала. Follower получает изменения лидера и поддерживает свою копию с теми же offsets. Producer пишет лидеру; обычное чтение тоже идёт к нему. Существуют настройки чтения с ближайших реплик, но для базового примера используем стандартный путь через лидера.
Партиция 0 топика replication-demo имеет реплики A, B, C. A — лидер. Новая запись появляется у A, затем followers копируют её. Пока B и C догоняют, у копий могут различаться границы журналов. Не всякая живая машина уже содержит последнюю безопасную историю.
Размещение копий на разных брокерах помогает пережить отказ одной машины. Если все находятся в одной зоне с общим источником питания, отказ зоны затронет их одновременно. Если одинаковая ошибка приложения записала неправильное событие, репликация добросовестно скопирует и его. Для длительного восстановления после ошибок отдельно планируют архив и резервное копирование.
ISR показывает синхронные реплики
ISR, in-sync replicas, — набор реплик, которые Kafka считает достаточно синхронизированными с лидером. В него входит лидер. Follower, который потерял связь или слишком долго не догоняет журнал, исключается. Когда он восстановится и догонит лидера, может вернуться.
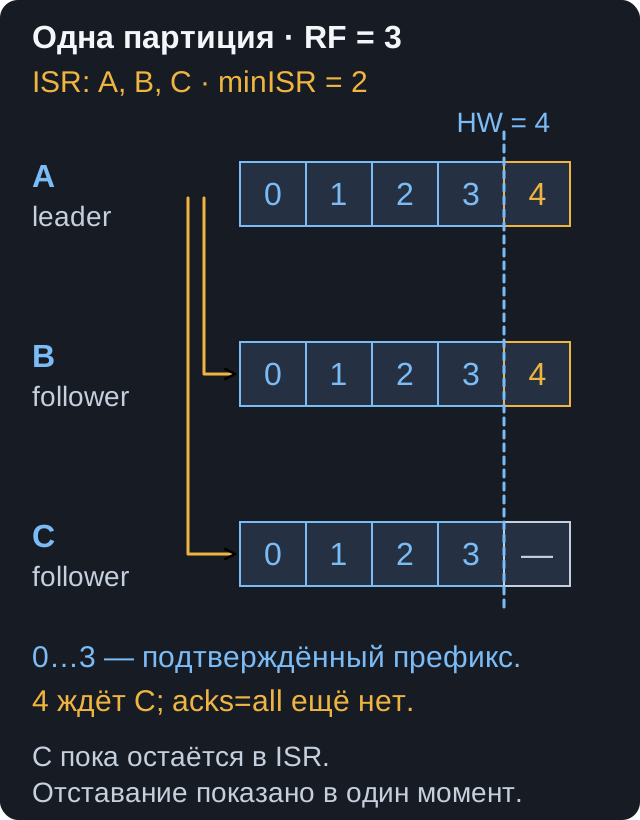
На схеме показан момент, когда C ещё входит в ISR, хотя запись 4 пока не скопирована. High watermark, HW, равен 4: подтверждённый для чтения префикс содержит записи 0…3. Это следующая граница, а не номер последней видимой записи. При текущем ISR {A, B, C} запрос acks=all для записи 4 ещё ждёт C; минимум 2 не разрешает забыть третью синхронную реплику.
ISR меняется во времени. В нормальном состоянии {A, B, C} соответствует RF=3. При проблеме B может остаться {A, C}. RF всё ещё равен 3: запланированная копия B существует в топологии, но сейчас не участвует как синхронная реплика.
Поэтому мониторинг различает under-replicated partition, где ISR меньше назначенного набора, и under-min-ISR partition, где ISR меньше разрешённого минимума. Первое означает сокращение запаса надёжности. Второе затрагивает возможность подтверждать новые записи по строгой политике.
Acks и minISR отвечают на разные вопросы
acks=all задаёт требование producer к подтверждению записи текущим ISR. min.insync.replicas задаёт минимальное число синхронных реплик, при котором такой запрос можно успешно обслужить. Уменьшение минимума ради прекращения ошибок ослабляет политику надёжности.
Пусть RF=3, min.insync.replicas=2, producer использует acks=all.
| Доступный ISR | Новая запись по этой политике |
|---|---|
| A, B, C | Подтверждение текущими тремя ISR; минимум 2 соблюдён |
| A, C | Подтверждение двумя ISR; минимум 2 соблюдён |
| A | Успешного подтверждения по политике нет: ISR меньше 2 |
minISR=2 не означает «при наличии трёх ISR ждать любые две и забыть третью». И acks=all само по себе не обещает три копии: если разрешён минимум 1 и ISR состоит из одного лидера, смысл «all» относится к этой одной реплике. Настройки producer и топика нужно рассматривать вместе.
При acks=1 producer ждёт только локальную запись лидера. min.insync.replicas=2 не превращает такой запрос в ожидание двух копий. В Kafka 4.3 при ISR ниже этого минимума лидер может принять и подтвердить такое добавление, но high watermark, граница безопасного чтения, не продвигается: новые записи станут видны consumer после достаточной репликации и восстановления необходимого ISR. Событие может потеряться при отказе лидера до копирования, хотя producer успел получить ответ. Транспортная идемпотентность также не создаёт отсутствующие копии на других брокерах.
Новый лидер должен иметь пригодную историю
Если A отказал, контроллер выбирает подходящую доступную реплику. Обычно безопасный выбор опирается на ISR. Новые версии Kafka также умеют учитывать eligible leader replicas, ELR: пригодность определяется сохранённой информацией о безопасности реплик. Для базового вывода достаточно одного правила: случайный follower не становится лидером только потому, что его процесс жив.
Если B и C были синхронными, один из них может стать новым лидером. Клиенты обновят метаданные и повторят операции; на время переключения возможны ошибки и задержка. При RF=1 другой копии нет. При отсутствии пригодных реплик партиция останется недоступной до восстановления безопасной копии.
Выбор отстающей реплики через unclean leader election может восстановить доступность ценой утраты части истории. Это отдельное административное решение, которое меняет гарантию сохранности. В учебной практике не будем его включать или изображать как безусловное продолжение работы после любого отказа.
Отказ брокера и rebalance группы — разные механизмы. Смена лидера партиции меняет место её обслуживания. Rebalance меняет владельцев чтения внутри группы consumer. Проблема брокера может вызвать задержки клиентских процессов и косвенно повлиять на группу, но это не одно действие.
KRaft хранит метаданные кластера
Контроллеры управляют метаданными: составом брокеров, топиками, размещением реплик и выбором лидеров. Современная Kafka использует KRaft, где контроллеры поддерживают согласованный журнал метаданных. Копии пользовательской партиции и quorum контроллеров выполняют разные задачи.
ZooKeeper встречается в старых схемах и установках Kafka. В Kafka 4.x новый кластер строят с KRaft; запускать отдельный ZooKeeper по старой инструкции для нашего образа не нужно. Локальный стенд с одним совмещённым broker/controller удобен для CLI, а устойчивость нескольких машин там отсутствует.
Самопроверка
Разбери отказ B и затем C в таблице выше. Назови отдельно число назначенных копий, размер текущего ISR, минимальный размер и требование producer. Затем объясни, почему при отказе лидера нужно знать пригодность других реплик, а не только их наличие.