Потоковый расчёт может фильтровать каждую запись независимо или хранить состояние между записями. Для временных агрегатов нужны границы окон, выбранная шкала времени и политика поздних данных. Восстановление должно согласовать накопленное состояние с позицией входного потока.
Spark Structured Streaming и Flink выполняют такие расчёты: читают источник, преобразуют записи, поддерживают состояние и записывают результат. Kafka может быть входным журналом и выходным топиком. Сам расчёт при этом выполняет движок.
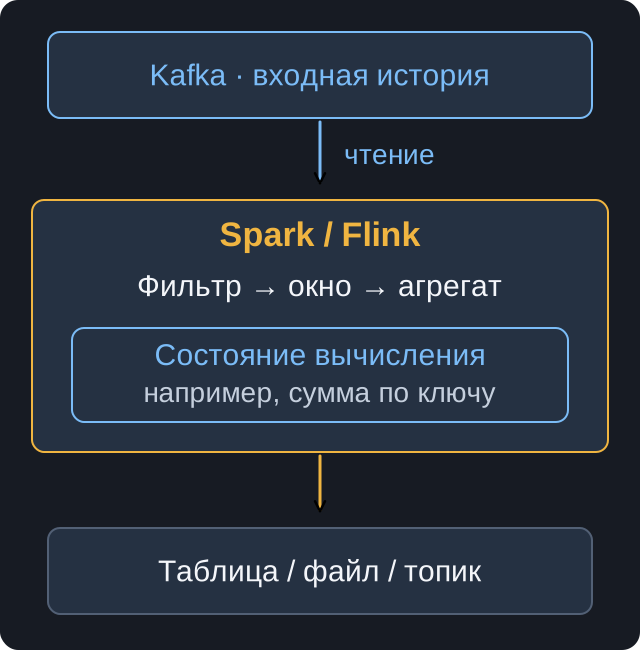
Обработка может помнить прошлое
Stateless-операция обрабатывает запись независимо: проверяет схему или пересчитывает единицы. Stateful-операция хранит состояние между записями: сумму окна, последнее состояние ключа или данные для соединения потоков.
Kafka предоставляет историю и позиции чтения. Вычисление суммы и её промежуточное состояние принадлежат приложению или потоковому движку. Если consumer перезапустился, одного знания последнего offset мало: нужна согласованная версия накопленной суммы.
Обычная consumer group делит чтение между экземплярами. Для агрегата по ключу движок может дополнительно перераспределять данные по ключу внутри вычисления. Партиция исходного топика и разделение состояния оператора — разные уровни, хотя оба влияют на параллелизм.
Event time отличается от времени получения
Event time — время самого факта, например значение occurred_at в записи. Processing time — время обработки этого факта в приложении. Событие произошло в 12:00:59, но получено в 12:01:10. По event time оно относится к минуте 12:00, по processing time — к минуте 12:01.
Для воспроизводимого отчёта часто важно event time: replay в другой день должен дать прежнюю минутную группировку. Однако результат зависит и от правила поздних данных. Источник должен корректно передавать время и единицы; отсутствие синхронизации часов или случайная смена миллисекунд на секунды нарушит расчёт.
Окно ограничивает участок бесконечного потока, по которому считается агрегат. Tumbling windows не пересекаются: [0, 60), [60, 120). Событие ровно на 60 принадлежит второму окну. Sliding windows пересекаются, а session windows соединяют активность до достаточно длинной паузы.
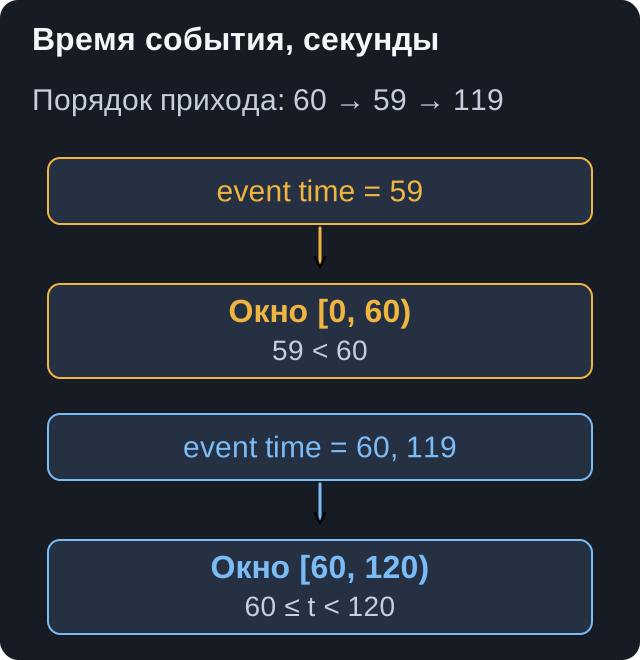
На схеме все события разрешены политикой поздних данных. Позднее поступление само по себе не меняет окно события; возможность обновить результат зависит от правил движка.
def window_start(event_time, size):
    return event_time // size * size

print([window_start(t, 60) for t in [0, 59, 60, 119]])
# [0, 0, 60, 60]
Это расчёт для неотрицательных секунд от выбранного начала отсчёта. Он помогает проверить границы, но не реализует распределённый оператор.
Watermark позволяет ограничить ожидание
Поток может доставить события не по времени. Watermark выражает продвижение event time по выбранной политике: обработчик считает достаточно старый участок времени завершённым и решает, когда выпускать результат и освобождать состояние.
Например, наблюдалось максимальное event time 100, разрешённое отставание в учебной модели 10 секунд, граница равна 90. Приход события со временем 85 требует политики поздних данных: отбросить с учётом, направить в отдельный поток или обновить уже выпущенный результат. Бесконечно ждать любой возможный поздний факт нельзя: состояние будет расти, а окончательный результат никогда не появится.
В настоящих движках продвижение зависит от входов, параллельных исполнителей и обработки простаивающих источников. Медленный вход может задерживать общую границу. Значение watermark не является обещанием, что источник физически уже никогда не пришлёт старое событие.
Spark, Flink и Kafka Streams
| Инструмент | Базовая модель использования |
|---|---|
| Spark Structured Streaming | Продолжающаяся таблица, DataFrame/SQL, обычно обработка микробатчами |
| Flink | Потоковые операторы, состояние по ключу, развитая работа с event time |
| Kafka Streams | Библиотека Java-приложения для обработки потоков Kafka |
Spark Structured Streaming объединяет знакомые преобразования таблиц с непрерывным источником. Отдельный trigger управляет запуском очередной порции. Старый Spark Streaming с DStreams встречается в прежних материалах; для нового знакомства здесь говорим о Structured Streaming.
Flink организует длительно работающий граф операторов и хранит состояние для окон, joins и других расчётов. Разница между инструментами шире лозунга «Spark всегда батч, Flink всегда real time»: важны режим, задержка, объём состояния, восстановление и поддержанный sink. Здесь изучаем общую модель; подробная установка и API Spark относятся к отдельной теме.
Checkpoint связывает состояние и прогресс
Checkpoint сохраняет согласованный прогресс источников и состояние вычисления для восстановления. У конкретного движка свой протокол сохранения. После отказа он восстанавливает состояние и повторяет ещё не закреплённый участок входа.
Пусть закреплены сумма 100 и входная следующая позиция 5. После checkpoint обработка добавила ещё 20, но процесс упал. Восстановление должно начать с суммы 100 и позиции 5, затем снова добавить 20. Если взять сумму 120 и старую позицию 5, результат удвоит эту добавку.
Для внешнего sink остаётся граница доставки из предыдущего урока: транзакционный или идемпотентный приёмник должен согласоваться с восстановлением. Checkpoint движка не превращает произвольный HTTP-вызов в один эффект. Полная гарантия зависит от source, состояния и sink вместе.
Локальная практика на Python
Для закрепления окон и состояния можно разобрать конечный список событий: определить окно, накопить сумму по event time и выделить поздние записи. Состояние здесь — обычный словарь, watermark уже задан. Это небольшая модель вычисления; scheduler, распределённый checkpoint и гарантии настоящих Spark/Flink в ней не реализованы.
window_start(event_time, size) возвращает начало непересекающегося окна [start, start+size). event_time — неотрицательное целое число секунд, size — положительное целое. Событие ровно на границе относится к новому окну.
| Ввод | Ваш вывод | Ожидаемый вывод | |
|---|---|---|---|
| (59,60) | — | 0 | |
| (60,60) | — | 60 | |
| (119,60) | — | 60 | |
| скрытый тест 4 | |||
| скрытый тест 5 | |||