Политика хранения определяет, какую часть журнала можно будет прочитать позже. Retention ограничивает историю по времени и объёму, а compaction очищает старые значения ключей. Это разные способы сокращения данных: для пересчёта всех переходов и восстановления последнего состояния нужны разные контракты хранения.
Журнал физически состоит из сегментов
Партиция растёт последовательным добавлением записей. На диске журнал разбивается на сегменты. В активный сегмент поступают новые данные; после достижения условий смены сегмента запись продолжается в новом файле. Такой механизм позволяет работать с порциями журнала вместо удаления отдельных строк как в обычной таблице.
Поэтому Kafka обычно не предоставляет приложению команду «удали произвольное событие с offset 12». Очисткой управляют политики топика. Чтение и commit группы не дают команду удалить прочитанный сегмент: другая группа может ещё не дойти до него.
Стратегию выбирают по назначению. Топик полной истории нужен для пересчёта переходов. Компактируемый топик подходит для восстановления последних значений ключей. Если заменить полную историю состоянием, восстановить каждый промежуточный переход уже не получится. Названия топиков помогают читателю понять этот контракт, а не только найти данные.
Retention ограничивает доступную историю
Retention определяет сроки и объём хранения. Для политики cleanup.policy=delete параметр retention.ms ограничивает возраст, retention.bytes — объём на одну партицию. Если задано оба ограничения, история может исчезнуть при срабатывании любого из них, а не только после одновременного превышения двух.
cleanup.policy=delete
retention.ms=604800000
retention.bytes=1000000000
Это семь суток и 1 GB на партицию. У трёх партиций логический ориентир объёма составляет примерно 3 GB до учёта реплик. При RF=3 нужно учитывать около 9 GB копий и дополнительное место для файлов, активных сегментов и операций обслуживания. Настройка retention не является точной квотой всего диска брокера.
Очистка выполняется фоном и по сегментам. Запись не обязана исчезнуть ровно через 604800000 миллисекунд после поступления. Для планирования восстановления важны фактическая нижняя доступная граница и запас времени до неё.
Если объём потока вырос, лимит размера может удалить историю раньше семи суток. Например, при 1 GB на партицию и постоянных 250 MB новых данных в час ориентир истории составляет четыре часа, даже если срок настроен на неделю. Для этого расчёта считаем одинаковую скорость, отсутствие сжатия и накладных расходов. Реальную глубину проверяют по журналу.
Compaction сохраняет последнее состояние ключа
Log compaction фоном удаляет старые значения ключа, для которого есть более новое значение в той же партиции. Читатель может восстановить последнее сохранённое состояние каждого ключа. Key записи не должен быть null; поле entity_id внутри value само по себе ключом Kafka не становится. Пустые байты ключа технически отличаются от null и допустимы.
offset 0  key=17  value=alpha
offset 1  key=28  value=one
offset 2  key=17  value=beta
offset 3  key=28  value=null
offset 4  key=17  value=gamma
offset 5  key=39  value=two
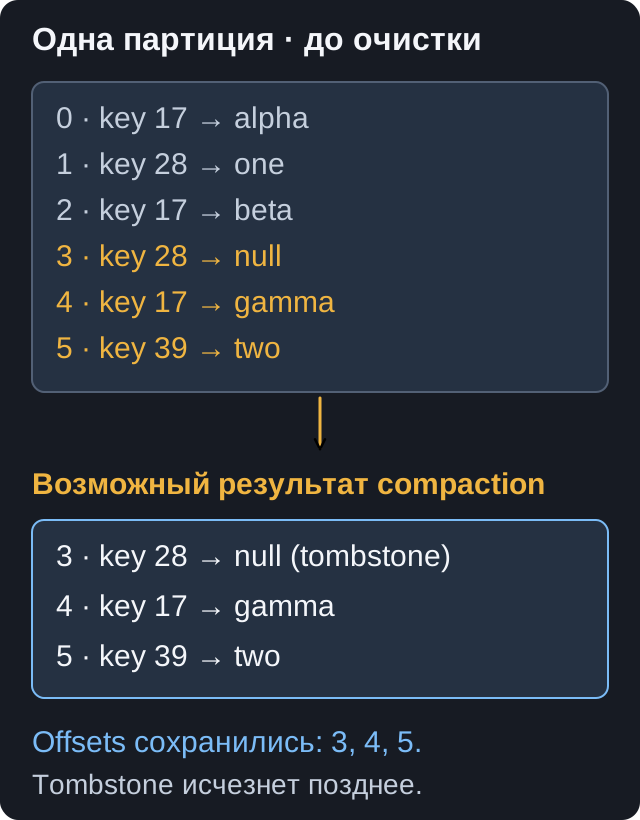
Для ключа 17 последним состоянием является gamma на offset 4. Cleaner может убрать старые версии на 0 и 2. До очистки consumer увидит все три. Поэтому compact не является мгновенной дедупликацией и не обещает, что в любом снимке ровно одна строка на ключ.
Номера оставшихся записей сохраняются: offset 4 не превращается в 0. Compaction учитывает порядок журнала, а не бизнес-поле occurred_at. Если источник отправит старую версию позже новой, она станет последней в журнале. Проверка версии в приложении по-прежнему нужна.
Tombstone обозначает удаление состояния
Tombstone — запись с key и настоящим null value. В компактируемом топике она сообщает удаление состояния этого ключа. В показанном журнале tombstone на offset 3 означает, что ключ 28 нужно убрать из восстанавливаемого состояния.
Строка JSON "null" или объект {"deleted": true} не становятся tombstone автоматически: у них есть ненулевое тело. Контракт может использовать такие бизнес-события удаления, но механизм compaction распознаёт именно null value записи Kafka.
Tombstone некоторое время сохраняется, чтобы читатели успели применить удаление, затем тоже может быть очищен. На срок влияет delete.retention.ms. Старый consumer, который слишком долго не читает и пропускает маркер, рискует оставить уже удалённый ключ в своём состоянии. Полное восстановление из чистого состояния и продолжение старого состояния поэтому имеют разные требования к доступной истории.
Политики compact и delete можно совместить: cleanup.policy=compact,delete. Тогда работает и очистка старых версий, и удаление истории по времени или объёму. Такой топик уже нельзя трактовать как бессрочный полный снимок всех ключей.
Практика
Таблица state_log содержит шесть строк показанной партиции. SQL NULL в колонке value обозначает настоящий tombstone этой учебной модели. retained_records — другой журнал, где после удаления сегментов остались offsets 8, 9, 10.
Выбери последнее значение каждого ключа, восстанови только существующие сущности и вычисли границы оставшейся истории. Выбор последней строки SQL моделирует логическое состояние; он не запускает cleaner и не обещает такой физический вид настоящего топика в этот момент.
Из state_log верни entity_key, offset_id, value только для последней записи каждого ключа, включая tombstone. Порядок по entity_key.