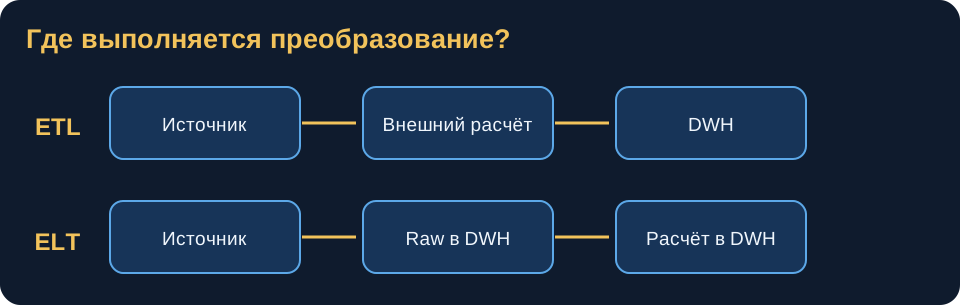
Любой конвейер между источником и аналитической таблицей должен получить данные, преобразовать их и загрузить результат. Эти действия обозначают буквами E (extract), T (transform) и L (load). В ETL основное преобразование выполняют до загрузки в целевое хранилище. В ELT данные сначала загружают в целевую среду, а преобразуют уже там.
Порядок букв описывает границу вычисления. Он не говорит, хорош ли конвейер, сохраняет ли он историю и какие инструменты использует. Одна и та же компания может применять оба подхода для разных источников.
Извлечение и загрузка тоже требуют правил
На шаге extract нужно решить, что считать полной поставкой. API может отдавать страницы, файлы могут приходить повторно, а запись с прошлой датой — измениться сегодня. Если забирать только новые идентификаторы, исправление старых строк потеряется. Поэтому контракт источника должен описывать границы выгрузки, изменения и удаление.
Transform бывает техническим и предметным. Привести строку к дате — техническая операция. Установить единицу суммы, связать разные коды одного объекта и выбрать, что считать активным состоянием, — предметные решения. Типы проверяют вместе с единицами и правилами расчёта: число должно быть правильно прочитано и правильно истолковано.
На шаге load решают, добавлять ли события, обновлять ли текущее состояние или пересчитывать затронутый период. Повторная доставка того же файла не должна удвоить итог. Для этого фиксируют идентификаторы поставок, устойчивые ключи записей и правила применения изменений. Аббревиатура ETL или ELT не освобождает от этих решений.
ETL: преобразование снаружи
При ETL отдельный процесс получает вход, проверяет его и создаёт подготовленный набор. Затем загружает его в DWH. Например, процесс получает CSV с суммой в копейках и временем в строке, приводит типы, удаляет технические повторы и отправляет в целевую таблицу проверенные поля.
Такой путь полезен, если преобразование требует специальной библиотеки, целевая система не умеет эффективно выполнять его сама или чувствительные поля нельзя передавать в DWH. Иногда объём данных после предварительной обработки значительно меньше. Но если внешний процесс отбросил исходные поля, а копию входа нигде не сохранили, новое правило расчёта потребует повторно получить данные от источника. Это может оказаться невозможным.
Отдельная вычислительная стадия требует мощности и наблюдения. Если источник отдаёт 100 МБ/с, а преобразование успевает обработать 40 МБ/с, очередь растёт перед ним. ETL не обязательно означает один перегруженный сервер: обработку можно распределить. Важно измерять узкое место реального конвейера.
ELT: преобразование в целевой среде
При ELT вход сначала записывают в raw-слой аналитической среды. Затем SQL-модели или другое вычисление внутри неё приводят типы, объединяют источники и строят витрины. Сохранённый вход позволяет повторить расчёт, если изменилось правило или обнаружилась ошибка.
ELT часто выбирают для современных аналитических систем, которые уже умеют параллельно обрабатывать большие объёмы данных. Преобразование можно выразить SQL и выполнять рядом с хранимыми таблицами. Но перенос работы внутрь целевой среды не уничтожает её стоимость. Если много тяжёлых моделей одновременно читают raw и мешают BI-запросам, нужны расписание, отдельные ресурсы или другая организация вычислений.
Загрузить файл в raw — ещё не опубликовать пригодный аналитический набор. Между ними остаются разбор, согласование, проверки и управление доступом. Поэтому время до появления файла и время до готовой витрины — разные показатели.
Конвейер как воспроизводимая программа
Data pipeline, или конвейер данных, связывает эти стадии зависимостями. Витрина должна запускаться после готовности своих входов за нужный период. Успешный запуск вчерашней загрузки не подтверждает готовность сегодняшней. Поэтому передают не только сигнал «завершено», но и идентификатор поставки, покрытый период или позицию источника. Оркестратор управляет запуском и зависимостями, а преобразование отвечает за смысл результата.
При переносе таблицы из одной системы в другую путь начинается с контракта: какие строки и изменения извлекаем, что означает начальное состояние, как трактуем пустые значения и время. Затем вход сохраняют, проверяют в staging, загружают в целевую модель и сверяют число ключей и контрольные показатели. Сменить место выполнения преобразования проще, чем исправить потерянные или неверно истолкованные данные.
SQL-модели и изменения схемы хранят с версиями. При ревью проверяют зерно результата, кратность JOIN, обработку NULL, поздних изменений и повторного запуска. Результат проверяют на небольшой известной поставке, а затем сверяют с источником. Какой инструмент запускает эти модели, обсудим в модулях оркестрации.
Что сравнивать при выборе
| Вопрос | ETL | ELT |
|---|---|---|
| Где основной расчёт | Во внешнем процессе до целевого DWH | Внутри целевой среды после первичной загрузки |
| Где хранить оригинал | В отдельном архиве, если он нужен | Обычно в raw-слое целевой среды |
| Как пересчитать по новому правилу | Нужны сохранённый вход и версия внешней обработки | Нужны сохранённый вход и версия внутренней модели |
| Где искать предел мощности | Внешний процесс, передача и загрузка | Вычисления и конкуренция запросов в целевой системе |
| Когда подход удобен | Специальная обработка или запрет передавать raw | Сильный аналитический движок и частый пересчёт из raw |
Граница относительна: конвейер может сначала загрузить файл в озеро, преобразовать его там и передать результат в DWH. Относительно озера это ELT, относительно конечного DWH — ETL. Поэтому в архитектурной схеме всегда указывайте, какую систему называете целевой.
Для устойчивости в обоих вариантах нужны одинаковые проверки: сколько входов получено, сколько принято, сколько отвергнуто, что произошло при повторе и как опубликован результат. Подход выбирают по ограничениям и измерениям, а не по тезису, что одна аббревиатура «современнее» другой.
Попробуйте на данных
В учебной базе для практики есть stg_orders с версиями заказов и полем status. Смысл преобразования не меняется от места запуска. Источник обещает статусы в нижнем регистре, но иногда присылает верхний. Можно строго отклонять такие строки, а можно после согласования правила нормализовать их. Сначала измеряют нарушения исходного контракта, затем выбирают поведение конвейера. Например, явное приведение выглядит так:
SELECT order_id, lower(status) AS status
FROM stg_orders
WHERE lower(status) IN ('new', 'paid', 'shipped', 'delivered', 'cancelled', 'refunded')
LIMIT 5;
В заданиях найдите нарушения строгого контракта, примените нормализацию и сравните число полученных и принятых строк по дням. Это одинаково нужно и внешнему ETL-процессу, и преобразованию внутри DWH.
Найдите первые десять дат загрузки, где статус в staging не соответствует контракту нижнего регистра. Колонки load_date, rejected_rows.