Kubernetes управляет контейнерными приложениями на группе машин — кластере. Он размещает приложения на подходящих узлах, поддерживает заданное число экземпляров и помогает обновлять их. Узлом может быть физический сервер или виртуальная машина.
Docker решает задачу упаковки и запуска контейнеров. Когда серверов несколько, появляются дополнительные вопросы: где есть свободная память, куда поместить ещё один экземпляр и как заменить приложение после потери узла. Kubernetes объединяет управление этими действиями. Его обычно используют для работающих сервисов и вычислительных задач; сам кластер также требует настройки и обслуживания.
Образ и запуск приложения
Kubernetes запускает готовые образы из реестра. Образ можно собрать Docker, но Docker Engine на узлах не обязателен: контейнеры может выполнять, например, containerd. Kubernetes не собирает Dockerfile и не устанавливает зависимости Python вместо системы сборки.
Пользователь передаёт желаемое состояние: образ, количество экземпляров, настройки и потребность в ресурсах. Кластер сравнивает его с фактическим состоянием и выполняет необходимые действия. Если приложение должно иметь три экземпляра, а осталось два, система пытается создать недостающий. Когда ресурсов не хватает, новый экземпляр ждёт размещения.
Это не разовый сценарий «выполнить команду и забыть». Контроллеры продолжают сравнивать описание с реальностью после запуска. Если вручную удалить один Pod из Deployment, он появится снова: желаемое число экземпляров не изменилось. Чтобы остановить сервис, меняют описание Deployment, а не борются с созданными им Pod.
Pod: единица размещения
Pod объединяет один или несколько контейнеров, которые запускаются на одном узле и используют общую сетевую среду. В обычном случае в Pod находится один основной контейнер. Для трёх независимо работающих экземпляров программы создают три Pod.
Несколько контейнеров помещают в один Pod, когда они тесно связаны. Например, один получает файлы сайта, а второй отдаёт их через веб-сервер. На схеме показано именно такое взаимодействие:
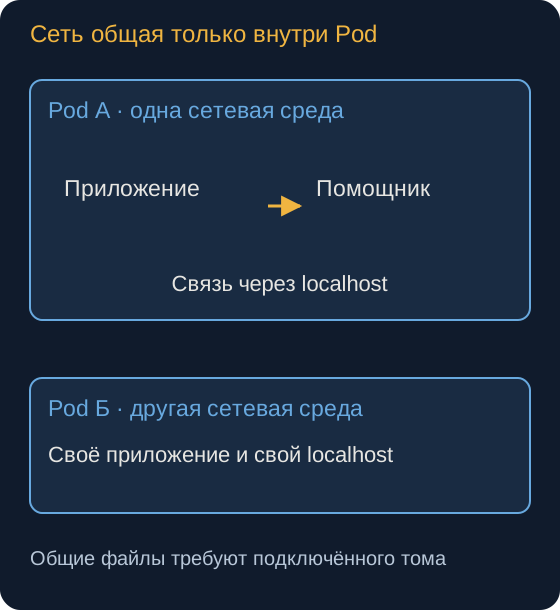
Приложение и его помощник в одном Pod обращаются друг к другу через localhost. Для обмена файлами им подключают общий том. У соседнего Pod собственная сетевая среда.
Pod имеет собственный срок жизни. При потере узла его не переносят вместе с оперативной памятью процесса: создаётся новый Pod. У нового экземпляра может измениться IP-адрес. Файлы только в записываемом слое старого контейнера вместе с ним не восстанавливаются.
Deployment: количество экземпляров и обновления
Deployment описывает группу одинаково настроенных Pod и управляет её обновлением. Обычно так запускают сервисы, состояние которых хранится отдельно — в базе, объектном хранилище или другом доступном им сервисе.
За выполнением описания следят контроллеры, процессы управляющей части Kubernetes. Deployment использует ReplicaSet — объект, поддерживающий нужное количество Pod. Если Pod удалён или потерян, контроллер создаёт замену. Самостоятельно создавать ReplicaSet для обычного Deployment не требуется.
При обновлении меняют образ в шаблоне Pod. В режиме постепенного обновления Kubernetes запускает новые экземпляры и поэтапно убирает старые. Приложение сообщает о готовности принимать запросы через readiness probe, настроенную проверку готовности. Это позволяет исключать ещё не готовые экземпляры из обычного обслуживания трафика. Проверка готовности может учитывать соединение с базой и завершение подготовки данных.
У проверок разные задачи. Readiness отвечает, можно ли сейчас направлять запросы в контейнер. Liveness помогает обнаружить зависший контейнер и перезапустить его. Startup probe даёт долго запускающемуся приложению время на инициализацию до других проверок. Если внешний сервис временно недоступен, не стоит бездумно объявлять контейнер «мёртвым»: массовые перезапуски могут усугубить сбой. Условие каждой проверки выбирают по реальному поведению программы.
Три экземпляра дают запас для обслуживания запросов, но без правил размещения могут оказаться на одной машине. Устойчивость к потере сервера требует учитывать, как экземпляры распределены по узлам.
Service: постоянная точка подключения
Клиенту неудобно следить за адресами отдельных Pod, которые создаются и удаляются. Service предоставляет устойчивую сетевую точку обращения к группе экземпляров. Обычный Service типа ClusterIP получает внутренний адрес; к нему также можно обращаться по имени через DNS кластера.
Чтобы определить участников, используют labels — метки объектов, например app: A. Selector — условие, по которому Service выбирает Pod с нужными метками. В обычной настройке запросы направляются к готовым участникам этой группы.
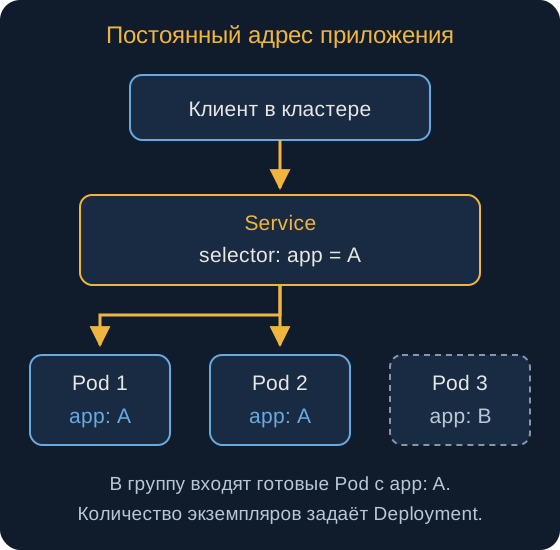
Два Pod с меткой app: A подходят условию Service, а Pod с app: B находится вне группы. Selector подбирают так, чтобы в неё входили только нужные экземпляры приложения.
Service не создаёт Pod и не задаёт их количество. После замены экземпляра обновляется список получателей трафика, а точка подключения к Service остаётся. При обрыве уже установленного соединения клиенту всё равно нужна обработка ошибки. Внутренний Service также не публикует приложение в интернете автоматически.
Управляющая часть и рабочие узлы
Описание приложения отправляется в API server, входной интерфейс управления кластером. Обычно для этого используют клиент kubectl. Контроллеры приводят объекты к заданному состоянию, а scheduler, планировщик, выбирает узел для каждого нового Pod с учётом ресурсов и ограничений.
На рабочем узле действует kubelet, агент Kubernetes. Он через среду выполнения организует запуск контейнеров Pod и сообщает об их состоянии. Эти процессы постоянно взаимодействуют: команда запуска заканчивается, а наблюдение за приложением продолжается.
Почему Pod может остаться в ожидании
Для контейнера задают request — ресурсы, которые планировщик учитывает при выборе узла, и limit — верхнее ограничение использования. Например, процессу указали request 1 GB памяти, а на каждом узле с учётом уже запрошенных ресурсов можно выделить только по 700 MB. Сумма свободной памяти на нескольких узлах не поможет: один Pod должен поместиться на одном узле. Он останется без размещения, пока не появится подходящий узел или не изменятся требования.
При превышении лимита контейнер может быть завершён из-за нехватки памяти; лимит CPU обычно ограничивает доступное процессорное время и может замедлить работу. Поэтому для вычислительной задачи полезно сопоставлять request и limit с реальным расходом, длительностью и размером обрабатываемых данных. Увеличить число реплик сервиса — не то же самое, что дать одному процессу больше памяти.
Вычислительные задачи и постоянные данные
Для программы, которая должна обработать файл и завершиться, подходит Job. Он отслеживает выполнение и может создавать новые попытки при сбое. CronJob создаёт Jobs по расписанию. Это отличается от Deployment, которому нужно постоянно поддерживать работающие экземпляры сервиса.
Повтор задачи способен повторить уже выполненную запись в базу. Поэтому программа должна безопасно обрабатывать повторы: например, различать поставки и не вставлять одну и ту же поставку дважды. Kubernetes управляет запуском и не знает, какие строки считаются дублями.
Данные, которые должны переживать замену Pod, сохраняют во внешнем хранилище или в постоянном томе. Несколько экземпляров программы сами по себе не создают реплики базы и её резервные копии. Для баз с собственным состоянием применяют отдельные правила хранения и управления; увеличение числа Pod не заменяет настройку репликации СУБД.
Если приложению нужен постоянный диск внутри кластера, Pod может запросить его через PersistentVolumeClaim (PVC). PVC связывает запрос приложения с подходящим томом. Новый Pod может снова подключить тот же том, если это допускают хранилище и режим доступа. Но PVC сам по себе не является резервной копией и не гарантирует, что том доступен из любого узла после аварии. Для данных, которые должны пережить отказ площадки, отдельно планируют хранение и восстановление.
Для простого сервиса пригодится ещё одно разделение: образ содержит программу, а конфигурация задаёт адреса и режим работы. ConfigMap хранит обычные параметры, Secret — чувствительные значения, которые нельзя класть в образ или публичный репозиторий. Само название Secret не освобождает от настройки прав и защиты хранилища кластера. При изменении настроек нужно понимать, когда приложение их перечитает и потребуется ли перезапуск Pod.
Для лабораторий на одном компьютере достаточно Docker и Compose. Kubernetes становится полезен там, где требуется совместное управление приложениями на узлах кластера: размещение, обновления, сетевой доступ и восстановление экземпляров.