Таблица выглядит одинаково в SQL-клиенте независимо от устройства хранения. Отличие проявляется, когда база читает данные. В строковом представлении рядом находятся значения одной записи. В колоночном — последовательности значений одного столбца.
Что меняет расположение значений
Пусть таблица logs содержит источник source, статус status, количество обработанных строк rows_loaded, время, идентификатор и длинный текст сообщения. Для суммы по источникам нужна лишь часть полей:
SELECT source, sum(rows_loaded) AS loaded
FROM logs
WHERE status = 'ok'
GROUP BY source
ORDER BY source;
Читать идентификатор, время и текст сообщения для этого результата не требуется. Колонка статуса нужна, хотя она не выводится: по ней применяется WHERE. В строковом хранении ненужные поля могут оказаться в тех же дисковых блоках, что и нужные. Колоночное хранение позволяет выбирать потоки данных по столбцам. Чем шире таблица и меньше выбранная доля столбцов, тем существеннее эта разница.
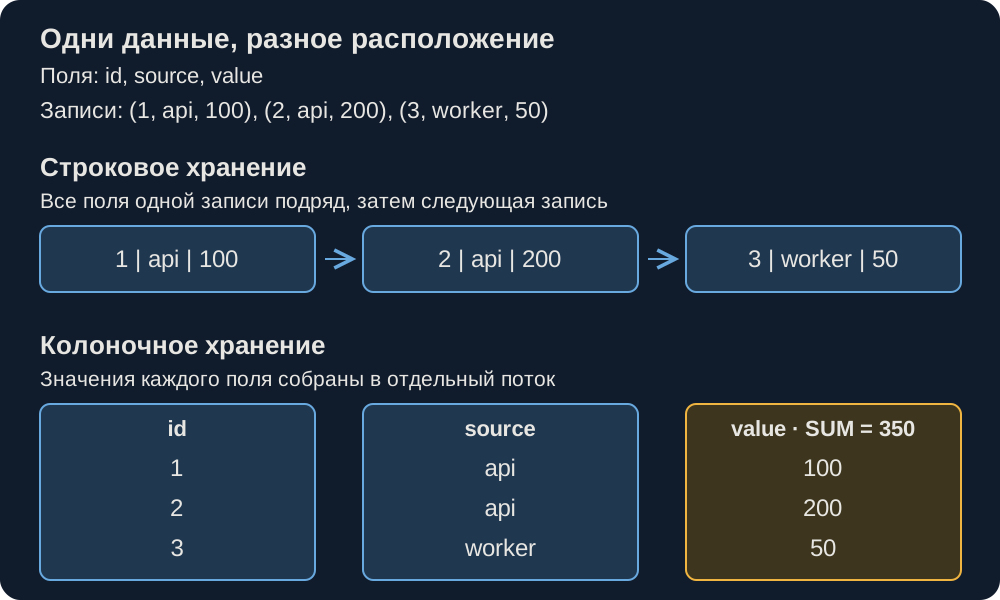
На схеме одни и те же три записи. В строковом варианте поле value перемежается с id и source. В колоночном его значения собраны в отдельный поток: для суммы достаточно прочитать 100, 200 и 50. Другие поля понадобятся только при соответствующих фильтрах или выводе.
Схема показывает логическое расположение значений. Физические файлы зависят от формата части MergeTree: Wide хранит колонки раздельно, Compact объединяет их в одном файле.
Как проходит запрос
Перед вычислением ClickHouse анализирует SQL и строит план: откуда читать, какие фильтры применить, что агрегировать и как упорядочить результат. Если ключ позволяет исключить диапазоны, часть данных не попадает в чтение.
Для выбранных диапазонов база читает сжатые данные нужных столбцов и распаковывает их. Затем проверяет status = 'ok', оставляет соответствующие значения source и rows_loaded и накапливает сумму для каждого источника. Последний ORDER BY source упорядочивает уже небольшой результат.
Векторное выполнение обрабатывает блок значений одной операцией: например, сравнивает массив статусов с 'ok'. Некоторые вычисления дополнительно используют SIMD — инструкции процессора, обрабатывающие несколько значений за раз. SIMD ускоряет отдельные операции внутри векторного выполнения.
Что дают несколько ядер
Параллельная обработка делит чтение и вычисление между несколькими потоками. Каждый обрабатывает свой диапазон и собирает промежуточные суммы. После этого состояния объединяются. Для суммы всё просто: суммы 500 и 700 дают 1200. Для среднего нужно сохранить и сумму, и число значений, а не усреднить два частичных средних.
Настройка max_threads ограничивает параллелизм запроса. Фактическое число потоков зависит от объёма работы; ускорение также ограничивают диск, пропускная способность памяти и одновременные запросы.
Стоимость запроса
У SELECT * исчезает выигрыш от выбора небольшой части столбцов. У группировки по уникальному идентификатору состояние почти столь же велико, как вход. Сложное преобразование строк может упереться в CPU. Большой JOIN требует построить структуру для соединения или использовать иной алгоритм.
Хороший ключ сокращает чтение диапазонов. Подходящий алгоритм и подготовленная витрина сокращают вычисления после чтения.